世界上有这么一家顶级公司,Transformer 是它发明的,诺贝尔奖拿了两个,全球营收常年前五,自己造芯片,自己还有搜索引擎。做大模型这件事,它什么都不缺。
它就是谷歌。不过,你们懂得。
四个月,谷歌发布了四款 Flash 模型,Pro 依旧遥遥无期。
几小时前,Gemini 3.8 Flash 来了,距离上一代 Gemini 3.7 Flash 才三周,距离 Gemini 3.6 Flash 六周。API 价格不变,每百万 tokens 输入 0.75 美元,输出 3.75 美元,同时发布的还有一个网络安全专用版本 Gemini 3.8 Flash Cyber,只对通过审核的安全机构开放,普通用户暂时用不了。(被 Anthropic 带坏了。)
谷歌在支线任务上,越走越远。
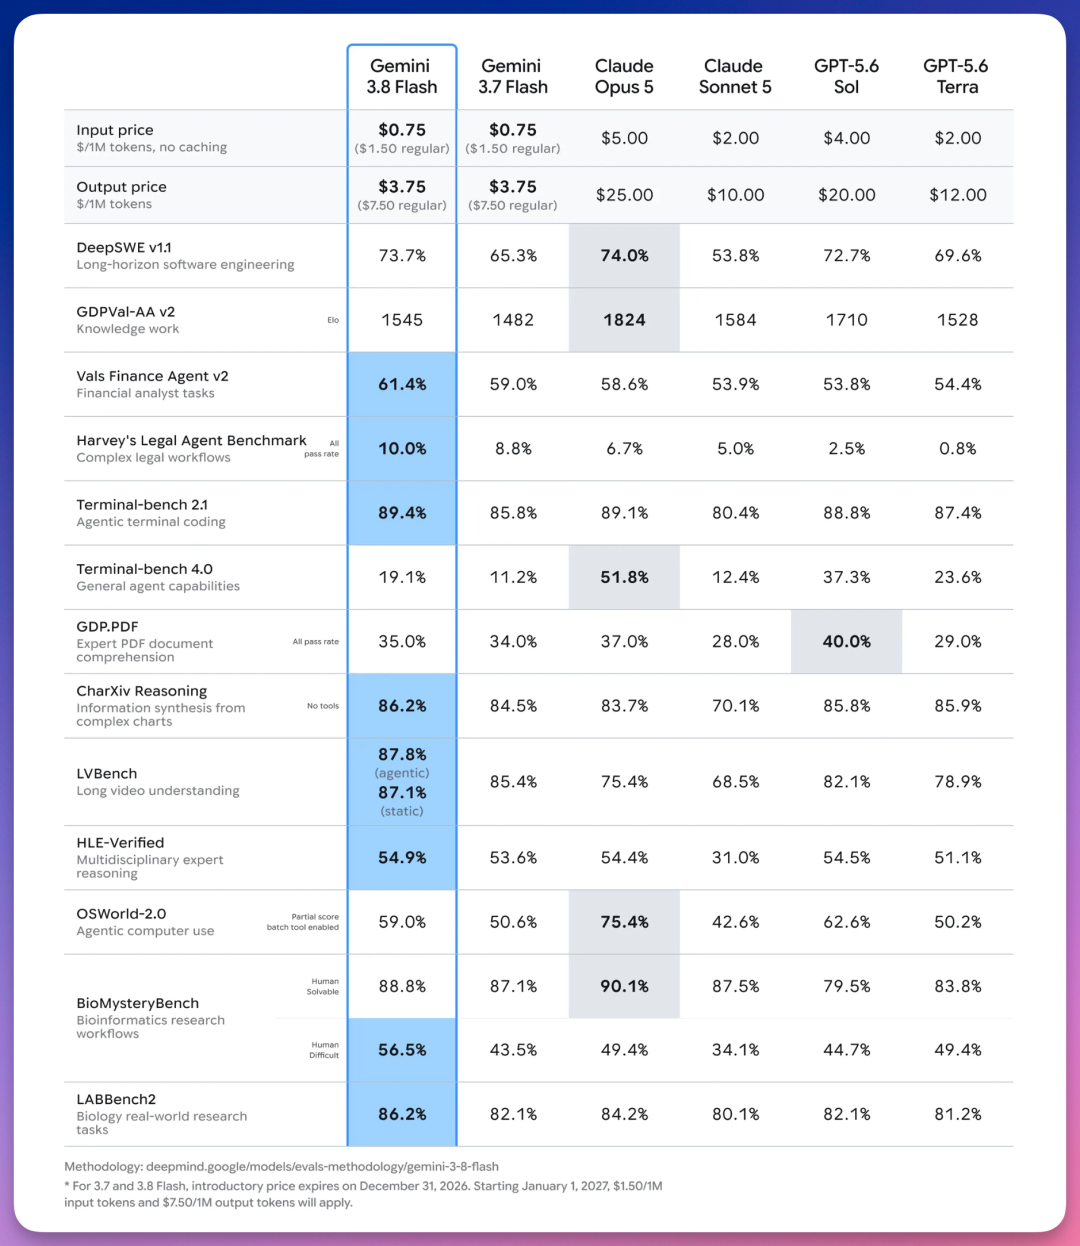
谷歌这一次似乎是有备而来。虽然发布的是 Flash,但它把老大哥 Claude Opus 5 和 GPT-5.6 Sol 拉到了同一张对比表里。
DeepSWE v1.1,专门考察模型独立完成真实、复杂软件工程项目能力。Gemini 3.8 Flash 完成逆袭,得分 73.7%,比 GPT-5.6 Sol 还高点儿,仅次于 Claude Opus 5 的 74.0%。
还有几项基准,Gemini 3.8 Flash 竟然拿下全场第一。合理怀疑这就是迟迟未发布的 Gemini 3.5 Pro。
金融智能体测试 Vals Finance Agent v2,Gemini 3.8 Flash 61.4%,最高分,Claude Opus 5 58.6%;法律智能体测试 Harvey Legal Agent Benchmark,Gemini 3.8 Flash 10.0%,还是第一,Claude Opus 5 6.7%;多学科专家推理 HLE-Verified,Gemini 3.8 Flash 54.9%,GPT-5.6 Sol 54.5%,Claude Opus 5 54.4%,三家几乎打了个平手。
谷歌是会做图的。它把模型价格专门放在了表格的前两行,以示强调。Claude Opus 5 输入 5 美元、输出 25 美元/百万 tokens,Gemini 3.8 Flash 是 0.75 和 3.75,价格差了 7 倍,金融和法律两个赛道 Flash 反而更强。
但毕竟是 Flash,再强你也上不了天。复杂编程,Gemini 3.8 Flash 和 Claude Opus 5 的差距一眼就能看出来。
Terminal-bench 4.0,考察智能体在复杂终端环境下的编程能力,Gemini 3.8 Flash 准确率只有 19.1%,Claude Opus 5 51.8%,差了将近两倍多。知识工作综合评分 GDPVal-AA v2,Gemini 3.8 Flash 1545,Claude Opus 5 1824。计算机操控 OSWorld 2.0,Gemini 3.8 Flash 59.0%,Claude Opus 5 75.4%。
单从这个跑分来看,Gemini 3.8 Flash 是个矛盾的集合体,偏科明显。
在最新的 Artificial Analysis 大模型排行榜上,Gemini 3.8 Flash 综合智商 59 分,相较于前代提升了 3 分。应该说已经跻身进中杯模型的 TOP 了。
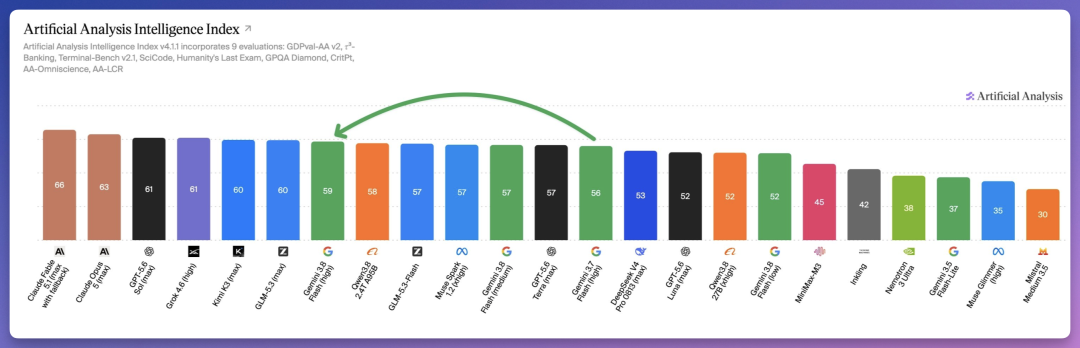
除了价格,Gemini 3.8 Flash 更值得一提的是它的 token 输出速度。每秒 305 个 token,排名第一,第二名是 Meta 的 Muse Spark 1.2,只有 154 个,Claude Fable 5.1 66 个,Claude Opus 5 56 个。
不过有开发者发现了一个细节,Gemini 3.8 Flash 完成同样的任务消耗的 token 数量几乎是 3.7 Flash 的两倍。另一位开发者补了一刀,「Claude Opus 5 完成同一个任务消耗的 token 量只有 Flash 的四分之一,光比每秒吐多少字不太公平。」
谷歌官方也承认了这一点,「Gemini 3.8 Flash 在复杂任务上会花更多时间思考,执行更多推理步骤,更频繁地调用工具。」它本身可能没有变聪明,但思考得更久了。
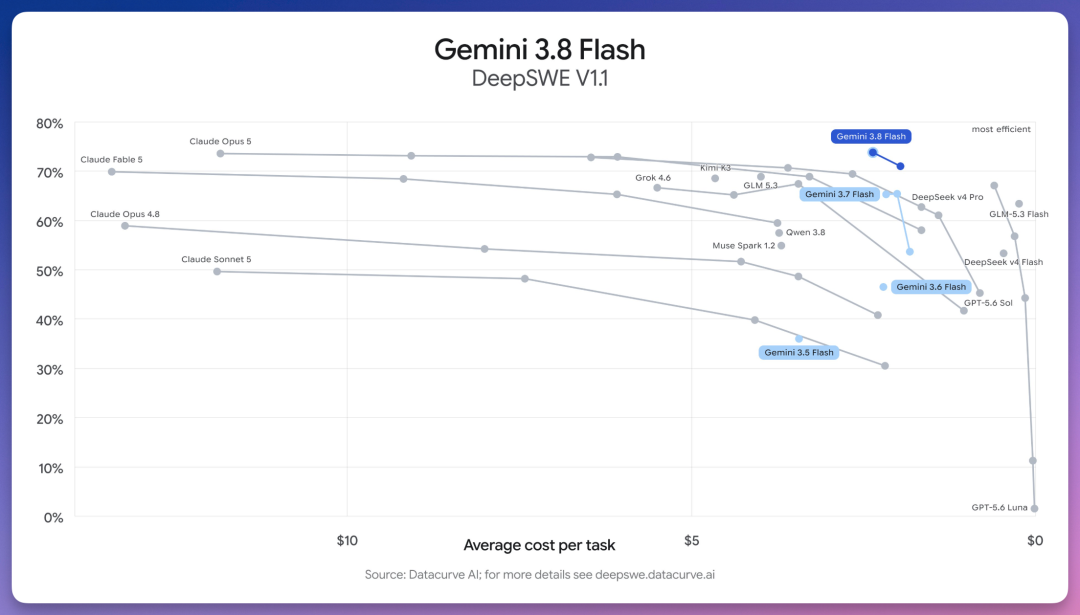
再来看看谷歌自制的一条大模型斩杀线,基于 DeepSWE v1.1。左下区域是被斩杀掉的其他模型。
网友们的反应,两极分化。
一位开发者在技术论坛上说「这周换到了 Gemini 3.7 Flash,发现它和 Opus 能打得有来有回,速度还快得多,谷歌是匹黑马。」另一位写前端的开发者接着说道,「它不会觉得自己比你更懂,不用反复纠正,编程是我用过最舒服的模型。」还有网友把 Gemini 当成没有广告和 SEO 垃圾的谷歌搜索来用,「好用得让人怀疑以前那些搜索结果都去哪了。」
但质疑的声音更多。
Gemini Flash 系列自带很强的刷榜感,「幻觉和其他模型比还是很大,上下文越长越不行。」有开发者翻看了 DeepSWE 的跑分历史,怀疑这个基准测试是不是被污染了,「每次新模型发布都在这个指标上屠榜,有点可疑。」
我单方面宣布,谷歌就是 AI 界掌管 Flash 模型的神。
开个玩笑。不过,Flash 配合谷歌最近恢复的学生认证送一年 Gemini AI 会员的活动,还要什么自行车。香就完事了。
成为付费用户可以阅读 谷歌 所有资料
了解更多 →