机器人前瞻9月16日报道,昨日,松延动力旗下通用具身智能子品牌Scalabot发布机器人模型HERON-Context Reinforcement Action Model(CRA)。
这是一种上下文—强化—行动机器人基础模型(A Context-Reinforcement-Action Robot Foundation Model),也是HERON技术架构体系下的第二个模型(首个为9月8日发布的HERON-World Model)。
该公司指出,这一模型能让机器人记住过去、从错误中学习,并将一次经验转化为下一次能力。
据官方介绍,HERON-CRA构建了三项关键能力,包括:
Cross-Embodiment Pretraining(跨本体预训练基座模型):可在各类本体上快速完成后训练与部署;
Context Expert(上下文专家):结合多模态能力,具备4D时空记忆能力;
极简、可快速适配的强化学习(RL)引擎;
由此,松延动力认为,模型可让机器人理解任务如何发生,从错误中持续修正,并将学到的能力跨越不同身体与任务进行迁移。
一、具备长时序记忆能力,可“蒙眼”抓物
松延动力展示的视频中,该模型完成了制作咖啡这一长程任务,包括接咖啡粉、把手柄放入压粉底座、压粉、装手柄、锁手柄、倒牛奶等操作,全程不到30秒。
HERON-CRA还实现了跨本体泛化,在放置咖啡杯和解锁、取下并清洗萃取手柄等一系列操作中,松延动力分别使用了机械臂ARX和轮式人形机器人Noetix M1两种形态的本体。不过,制作咖啡任务中的操作均由夹爪完成,且从视频观察,机械臂的操作稳定性似乎存在不足。
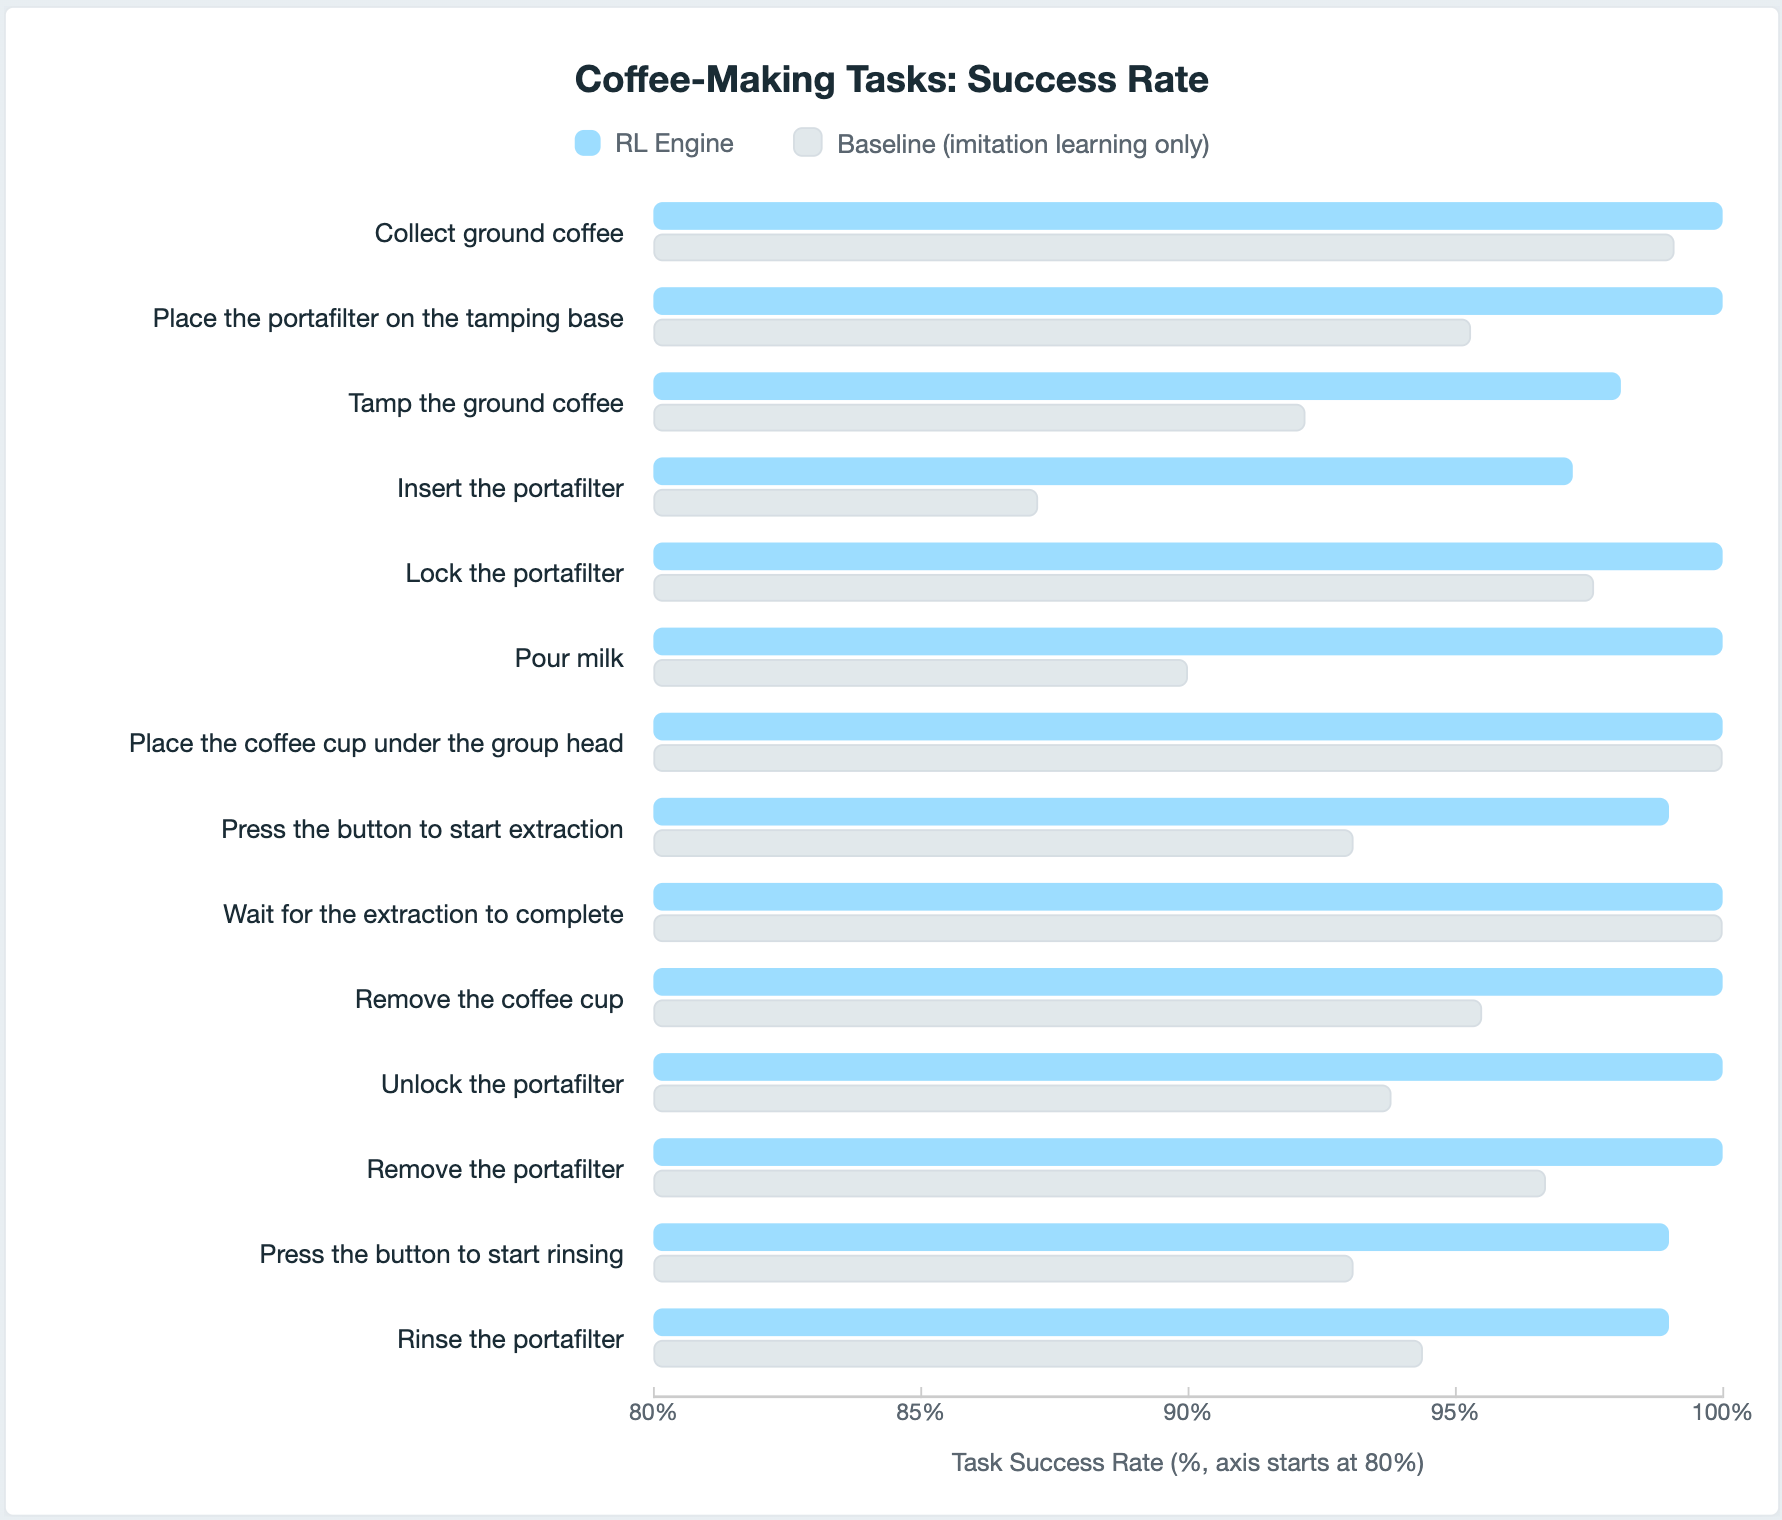
在咖啡制作任务的成功率上,松延动力将RL Engine与纯模仿学习基线(Baseline,imitation learning only)做了对比。据官方图表,RL Engine在多数环节上领先。
松延动力还表示,HERON-CRA具备从干扰中恢复的能力。视频中,当人为将杯子拿开时,机械臂会追踪杯子、尝试抓取。
同时,基于跨本体预训练,HERON-CRA在一定程度上具备物体与位置的泛化能力。松延动力透露,模型经少量数据后训练,即可抓取任意桌面上任意位置的物品。
从视频来看,该模型可以抓取不同物品,在人为干扰下也能较快调整;即使在运行中途用黑布遮挡部分视觉信号,操作仍能继续执行,一定程度上体现了HERON-CRA对视觉输入缺失的鲁棒性。
另外,HERON-CRA还可以完成灵巧操作,如把芹菜、黄瓜切段,秋葵去蒂;不过视频中切段的长度并不均匀。
该模型还可以完成柔性物体的精细操作:机械臂能叠放、卷曲袜子,也能识别不同颜色的袜子完成同一操作,但耗时较长,整个流程超过一分钟。
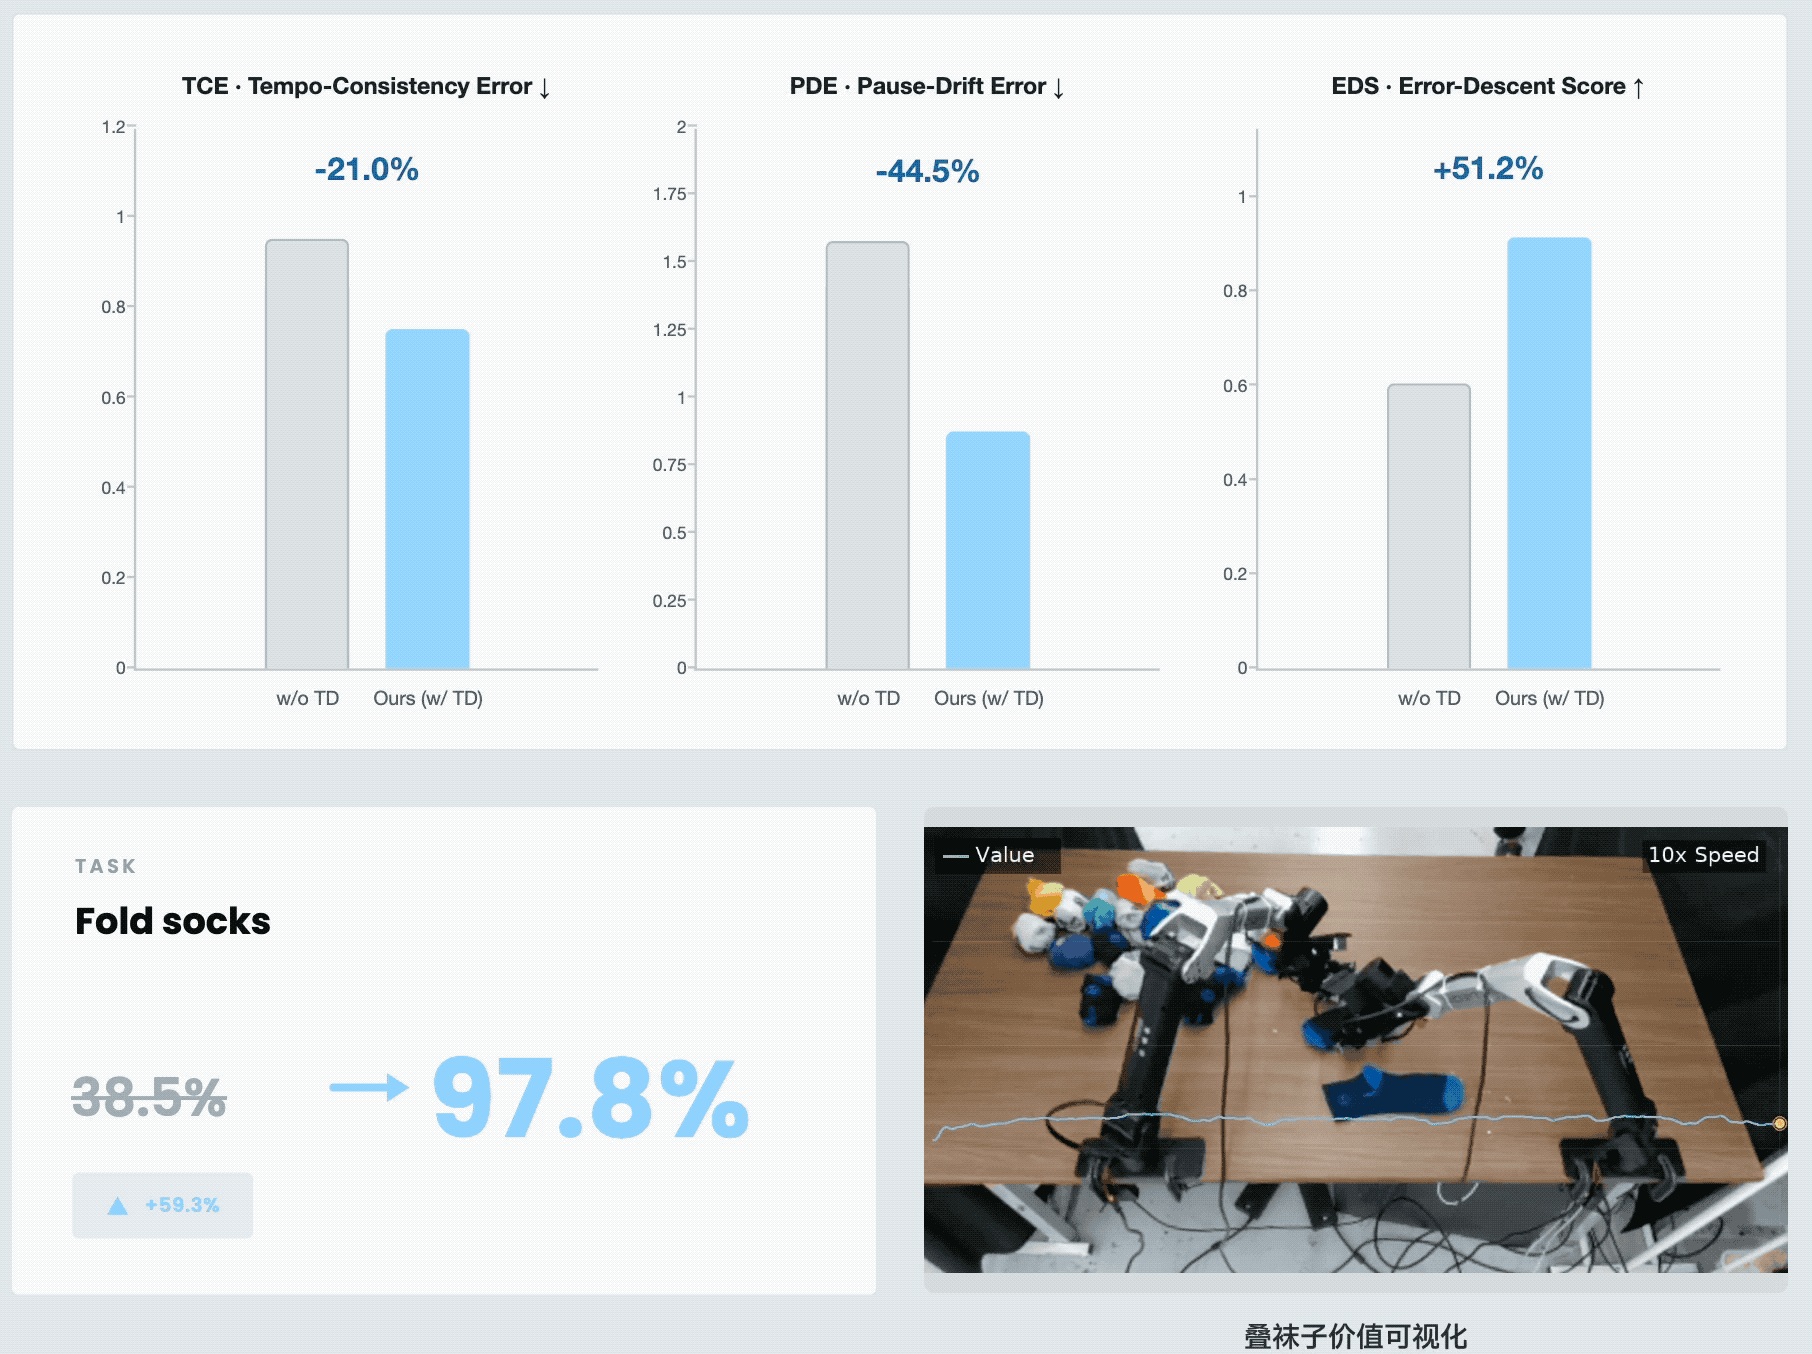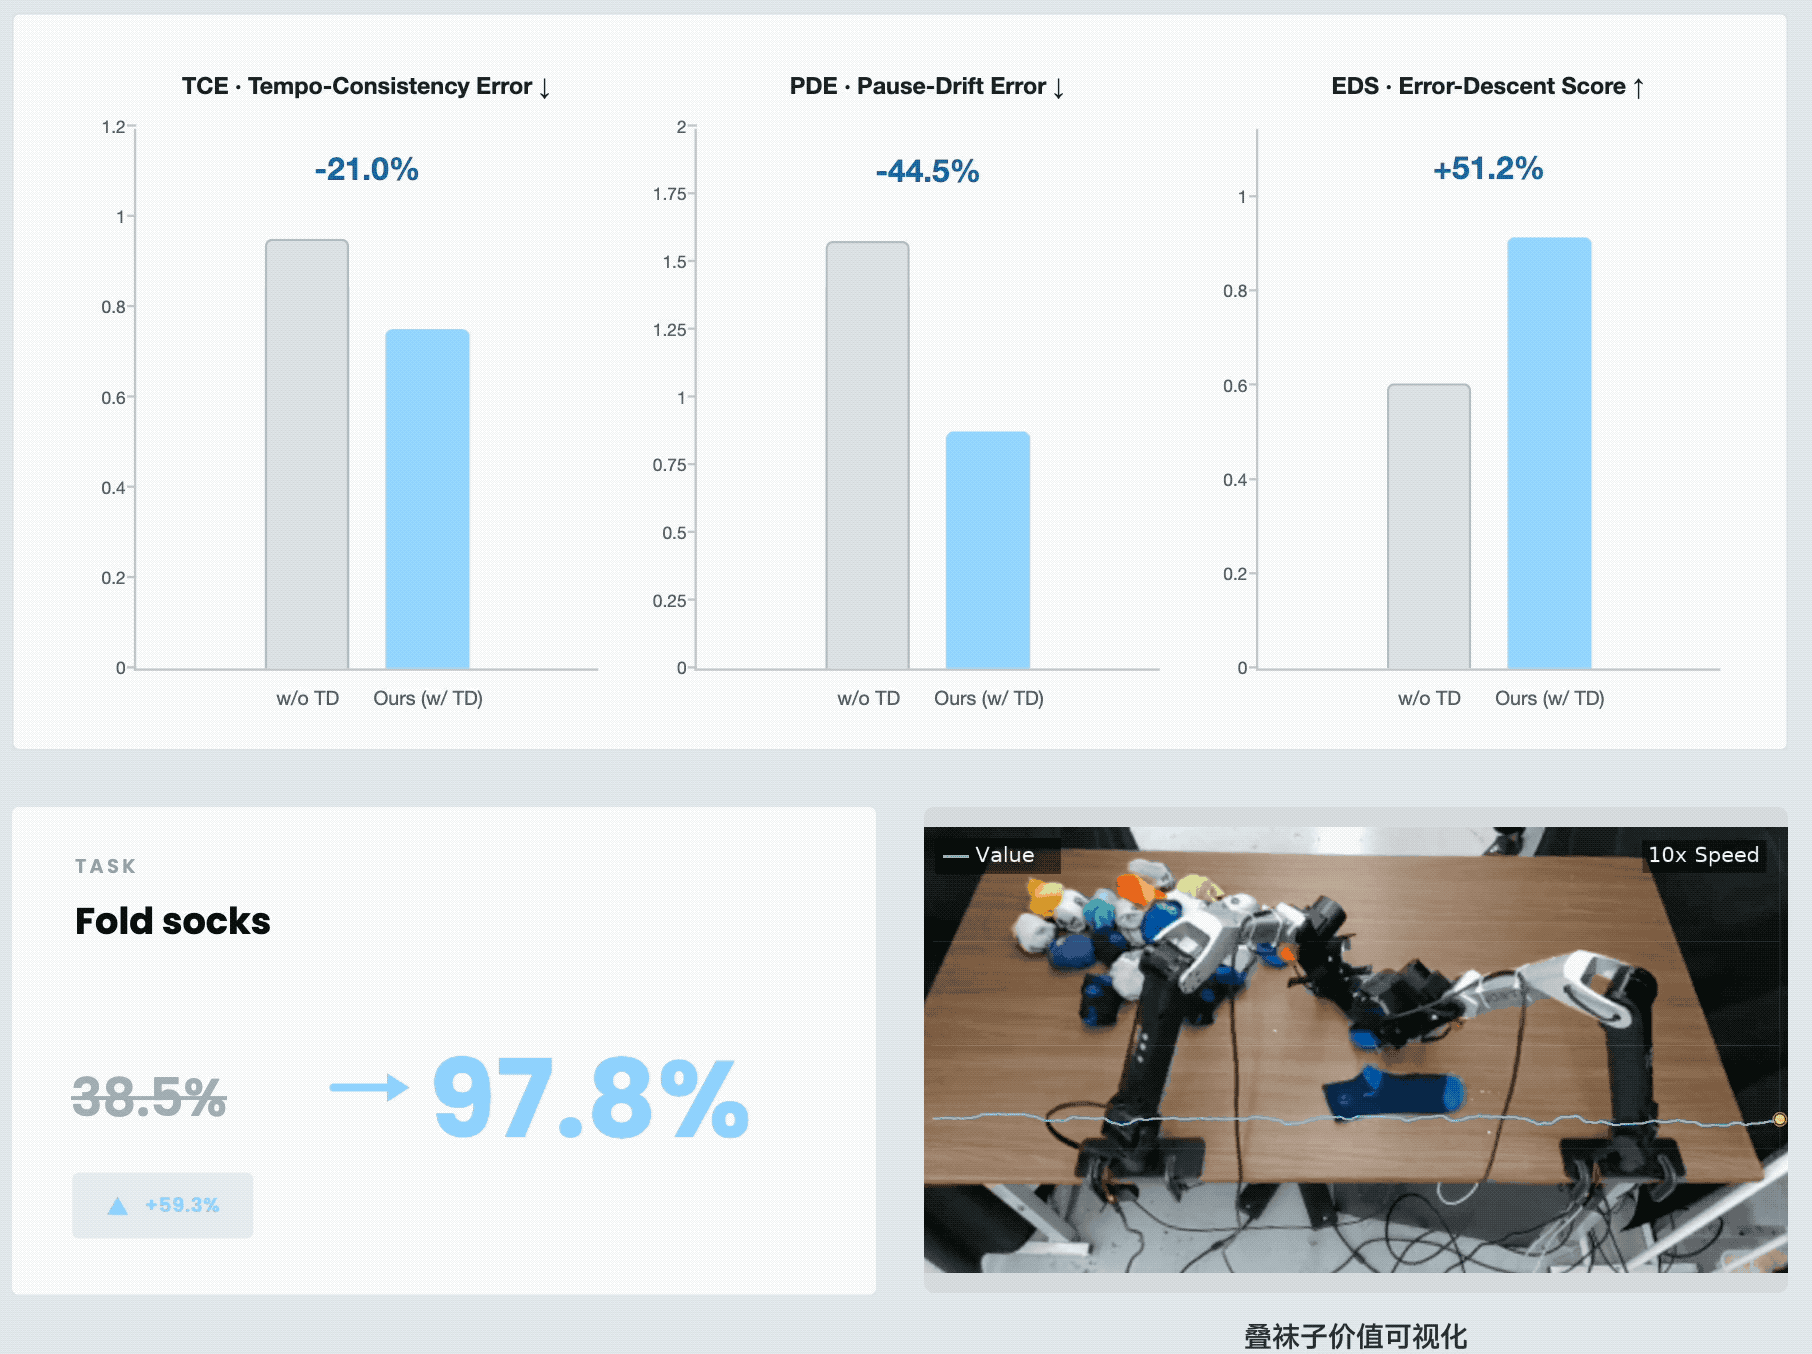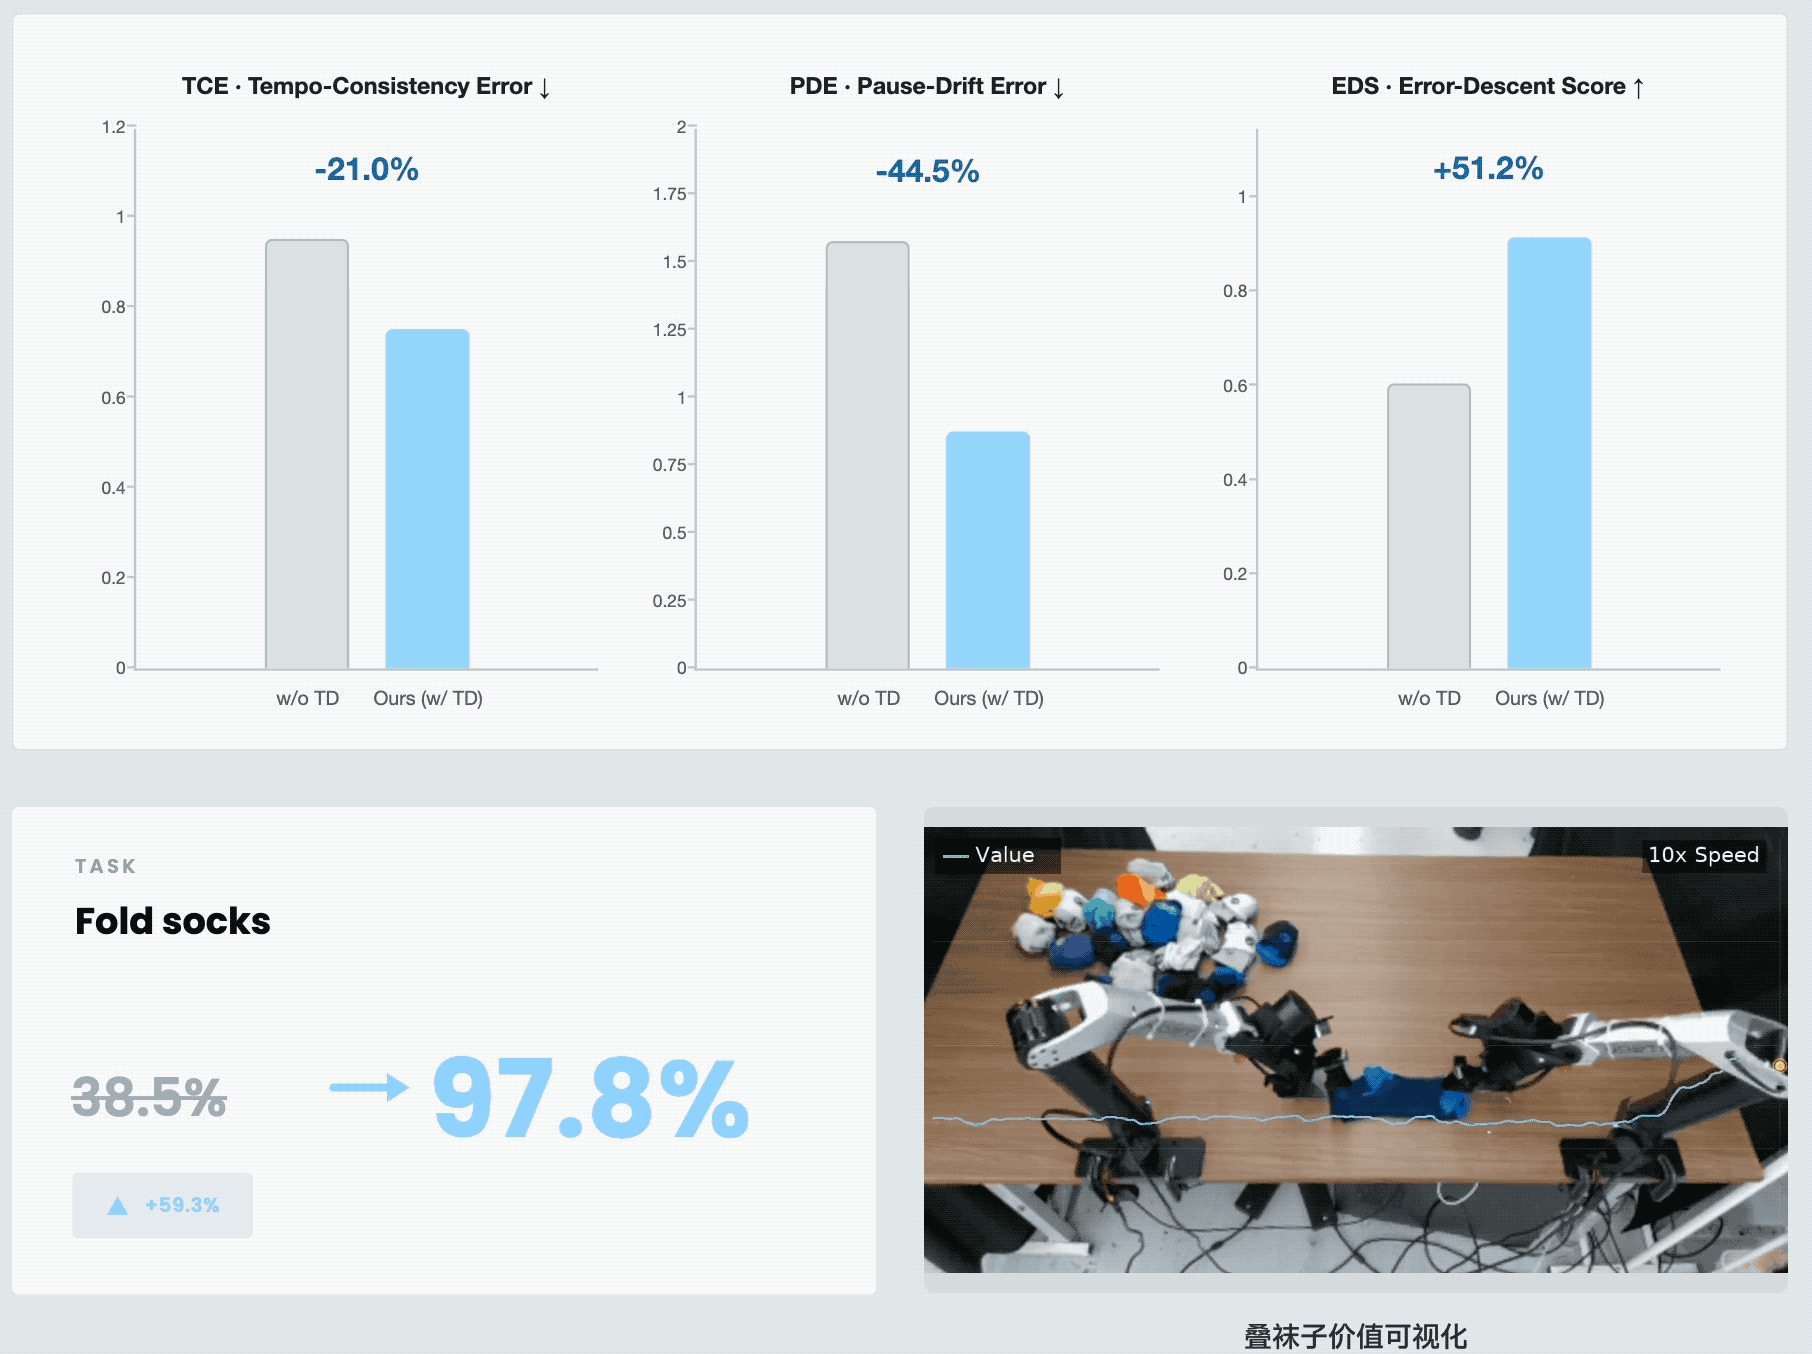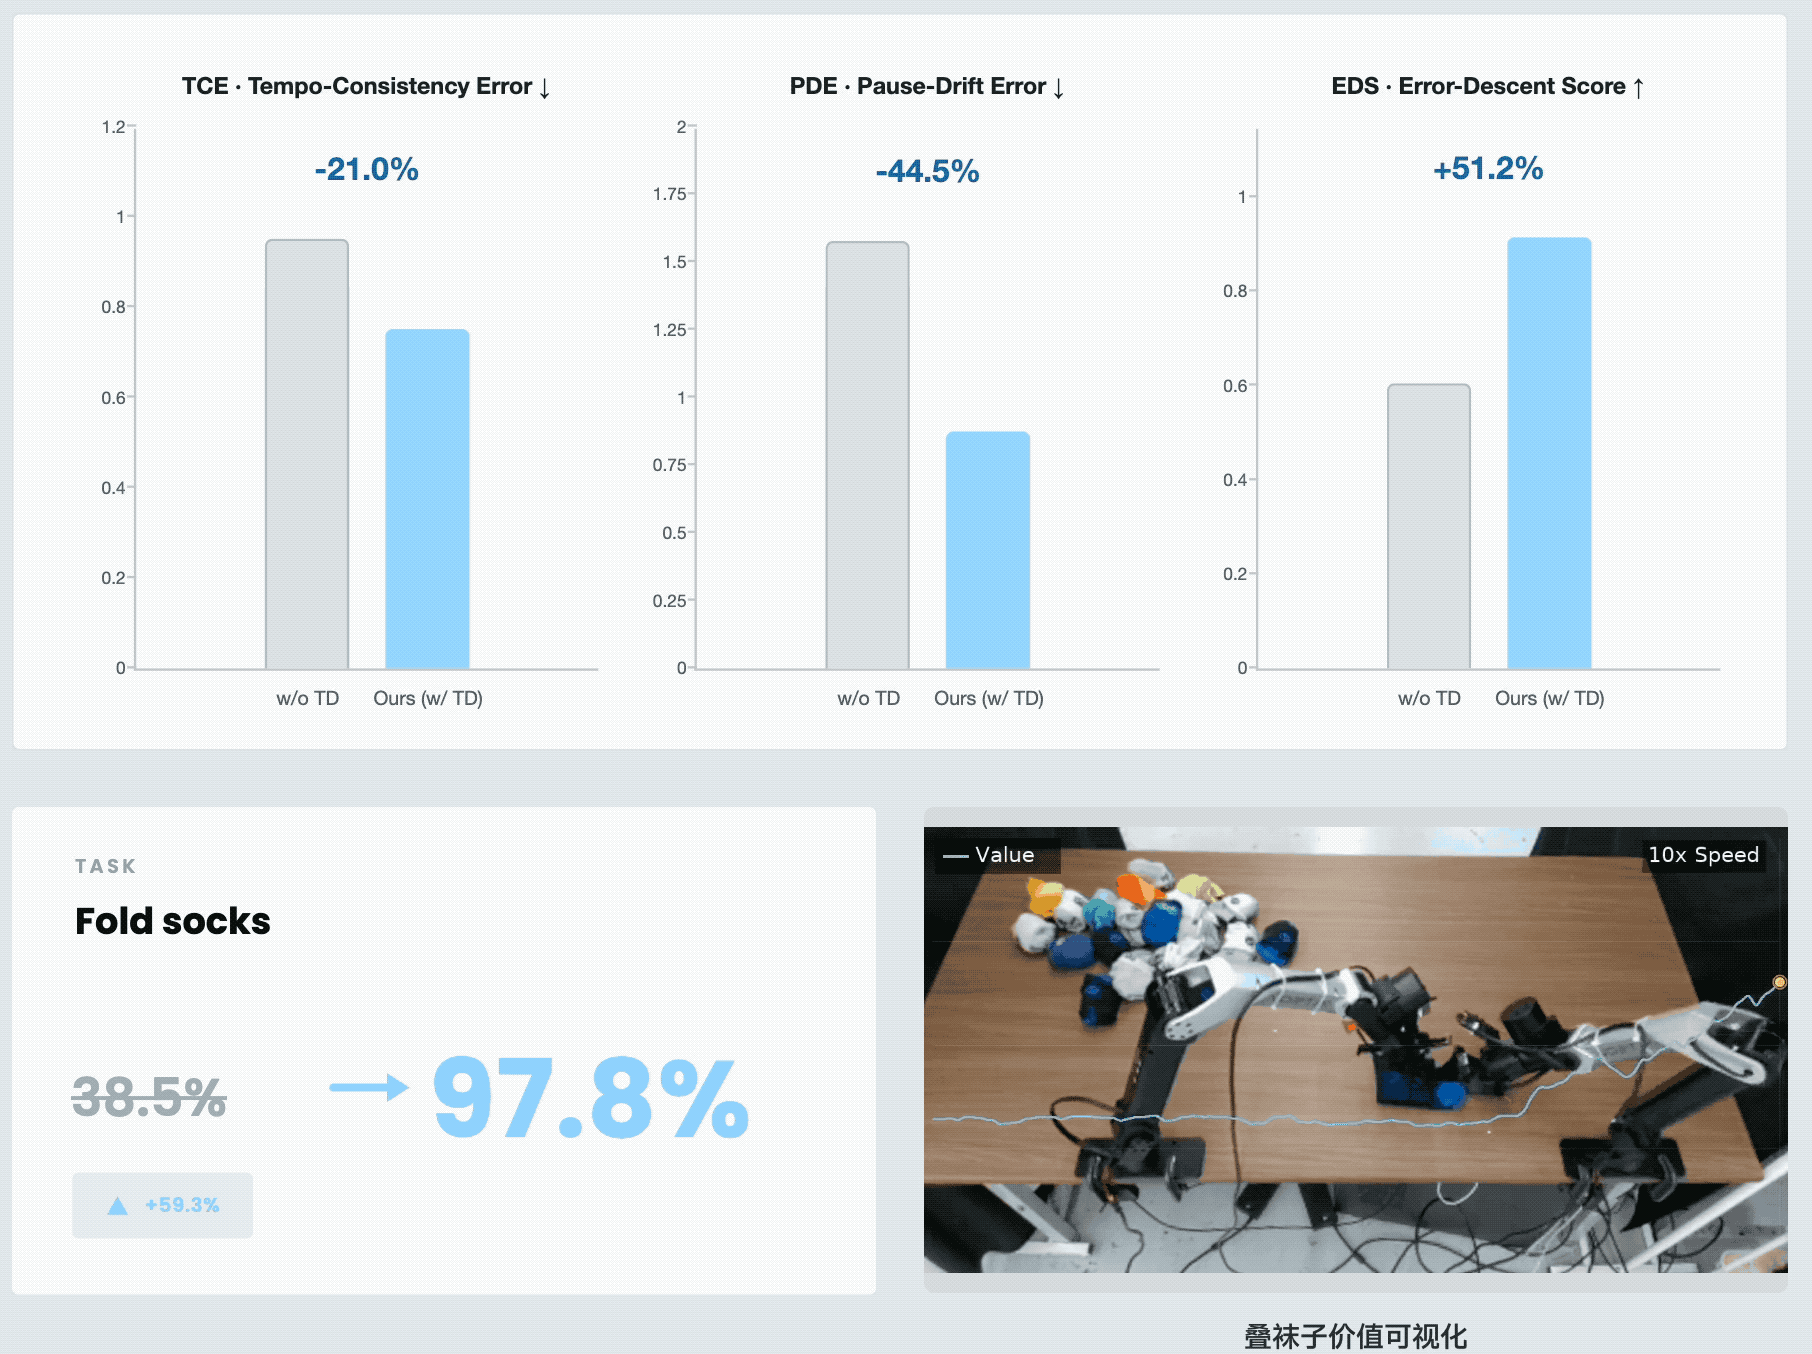
在此项任务上,松延动力指出,仅模仿学习的基座成功率为38.5%,而开启RL Engine后,成功率提升至97.8%。该公司还对时序鲁棒性和失败敏感性提升做了定量检验,HERON-CRA在三项指标上占优,即扰动下读数波动更小,真实出错时读数下降更早、更充分。
(注:松延动力称,时序鲁棒性由变速一致性TCE(Tempo-Consistency Error)与暂停漂移衡量PDE(Pause-Drift Error),TCE和PDE越低越好,失败敏感性由错误阶段下降响应衡量EDS(Error-Descent Score),EDS越高越好)
HERON-CRA还具备长时序记忆能力,目前可支持超过1分钟的记忆时长。视频演示了20次以上的杯子调换,该模型均成功猜中球所在的杯子。
给定一段记忆并配合相应的语言指令,HERON-CRA便能跟随指令完成任务,即单次示范学习(In-Context Learning)。
松延动力还展示了HERON-CRA更进一步的记忆能力:在长时序记忆与单次示范学习的配合下,该模型能把被人为弄乱的三个玩具放回原位。
二、提出三项关键能力,未来将进一步验证
围绕让机器人能够记住过去、从错误中学习,并将一次经验转化为下一次能力这一目标,松延动力称,HERON-CRA构建了Context Expert(上下文专家)、RL Engine(强化学习引擎)与Cross-Embodiment Pretraining(跨本体预训练基座模型)三项关键能力,即让机器人理解任务如何发生,从错误中持续修正,并将学到的能力跨越不同身体与任务进行迁移。
具体来看,Context Expert将记忆能力与物理建模能力相结合,把带有时序信息的4D压缩token接入Transformer进行训练。
松延动力表示,这一方式使模型具备了场景中的空间历史记忆能力,并展现出基于长时序上下文的快速学习能力(In-Context Learning)。
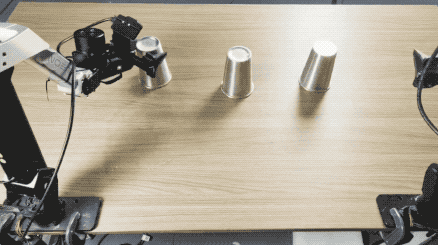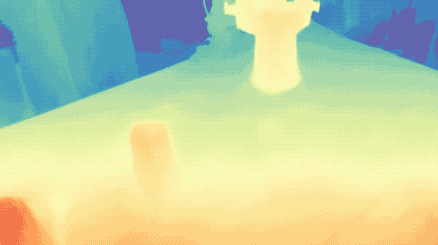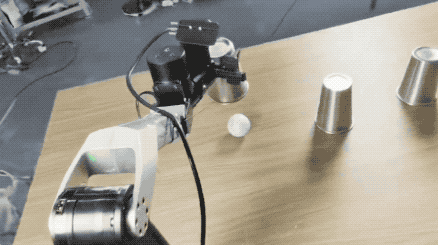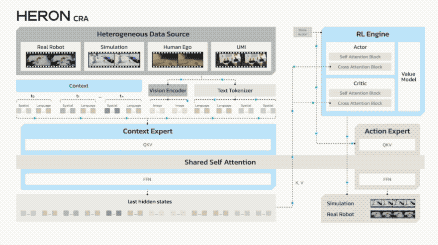
在松延动力的技术博客中,这一实现过程被详细拆解:首先,Context信息由空间token与语言指令token沿时间维度拼接而成,语言指令的接入确保模型习得对历史多任务变化的认知。
随后,Context信息再与当前图像及语言指令token拼接,一并送入Context Expert训练;Context Expert与Action Expert则以Mixture of Transformers(MoT)的形式联合学习。
由此,Context Expert在学习时空信息的同时,也保留了VLM对图像的理解能力;其蕴含多维信息的K、V参数则共享给RL Engine,用于后续训练。
在强化学习引擎层面,松延动力认为应围绕两个目标构建:其一是奖励可靠、可扩展,其二是训练框架极简、统一。
基于此,松延动力设计了一套RL Engine:价值模型(Value Model)负责提供稠密、稳定的奖励信号,具备时空感知的策略网络与HERON-World Model共同支撑离线与在线训练。
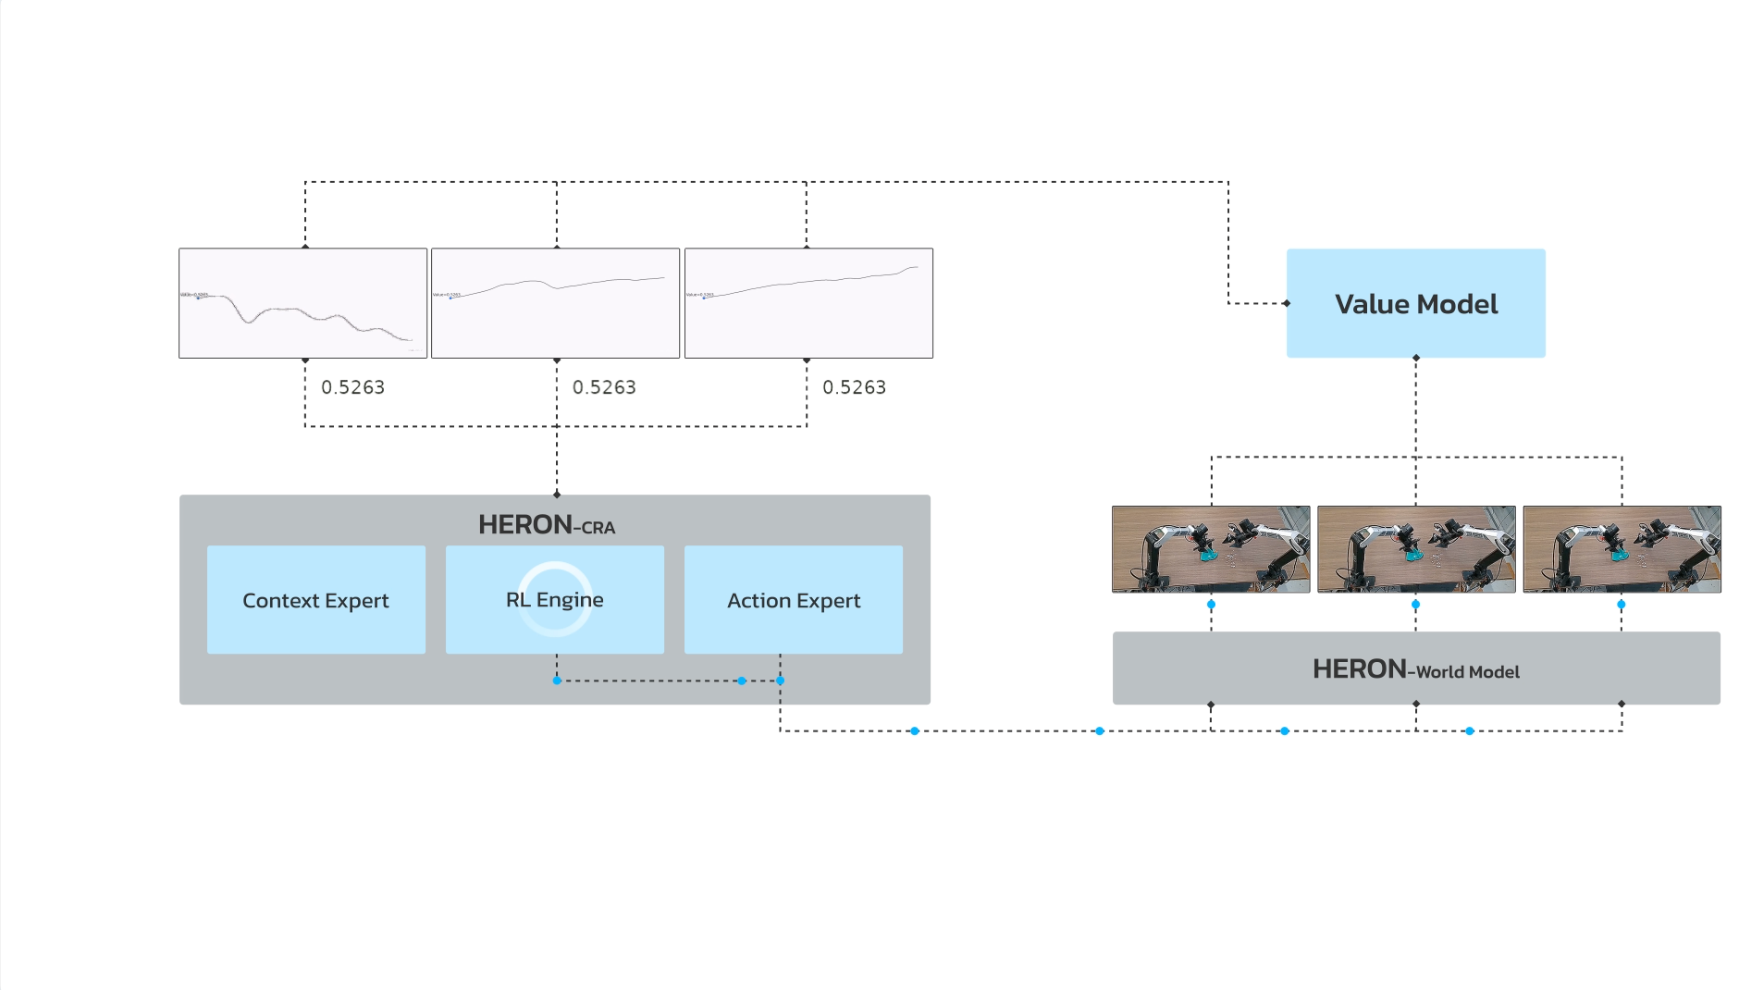
松延动力指出,这样的设计使RL Engine与基座模型解耦,可实现即插即用。
但在构建中,松延动力在价值模型层面遇到了两大问题:失败数据缺失,以及逐帧回归缺乏时序一致性约束。
松延动力的解决办法是,将价值锚定在任务结果上,并引入时间差分(Temporal Difference,TD)约束以规整整条价值曲线,轨迹终点由任务的最终结果定价,中间每一帧的价值被下一帧价值约束;结果信息由此沿轨迹反向回传,逐帧修正价值估计。
由于仅依赖真实数据时样本效率较低,该公司又引入了基于HERON-World Model的数据Rollout,从真实数据中采样状态作为起点,让策略在世界模型中执行一段动作序列,生成对未来的视频预测。
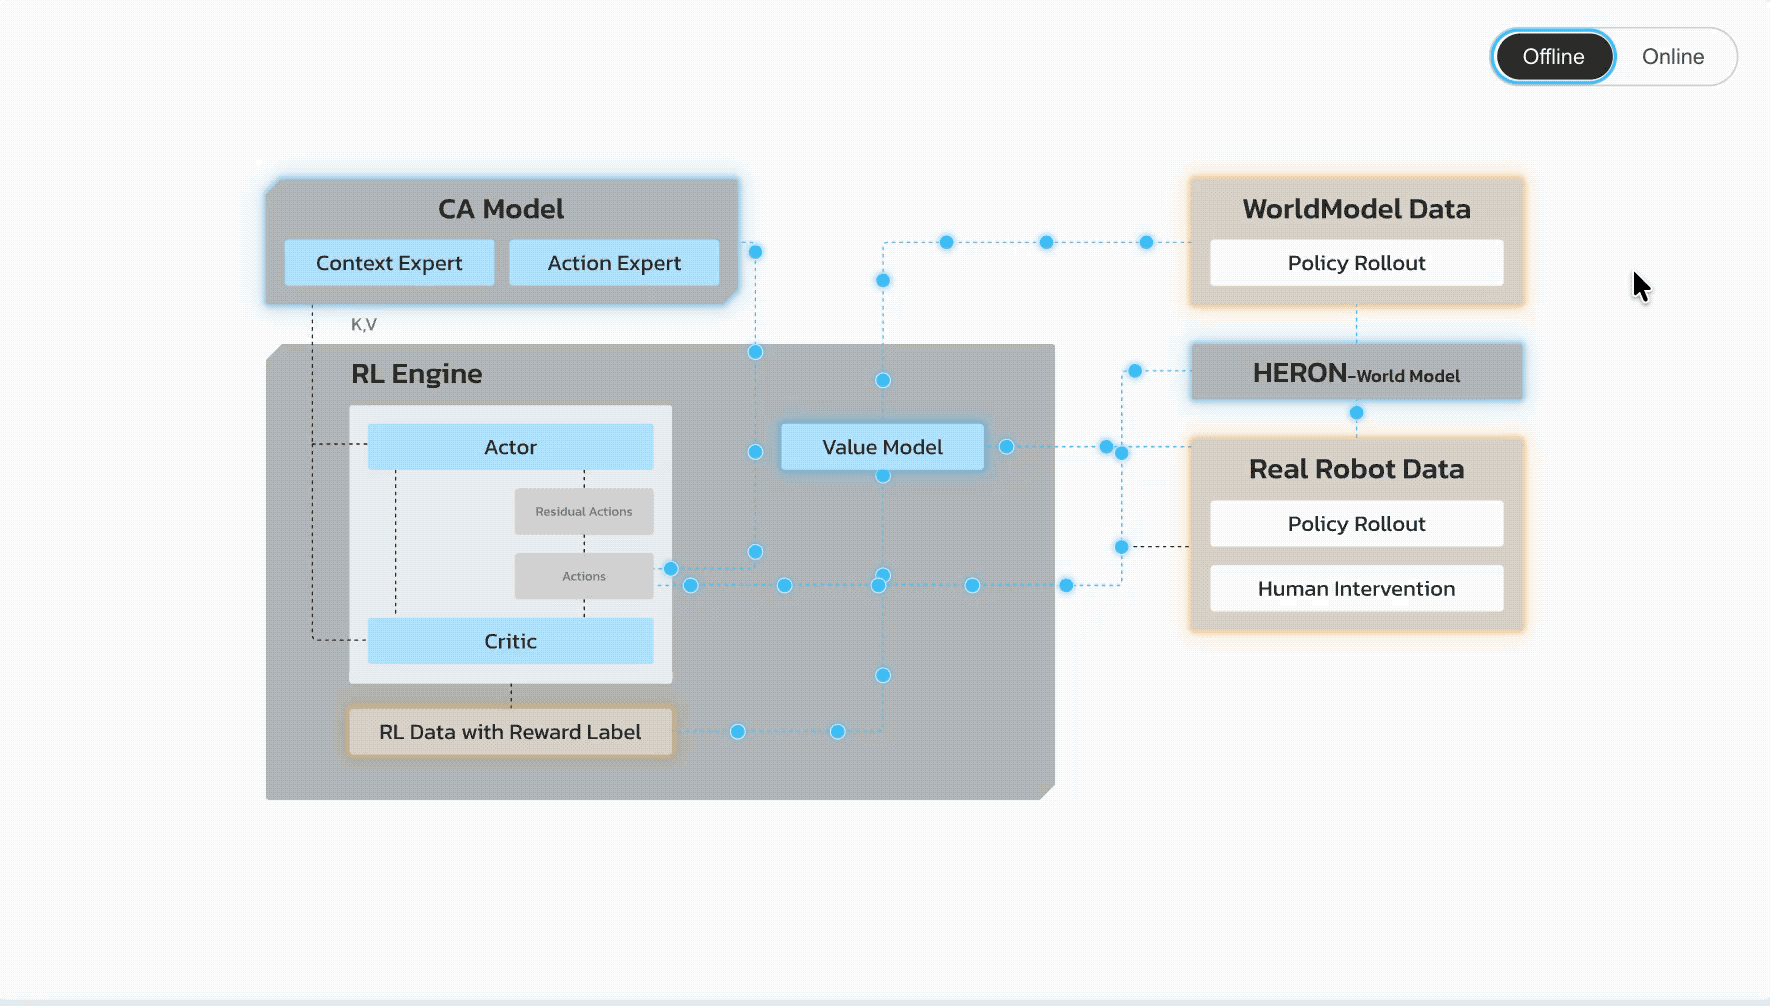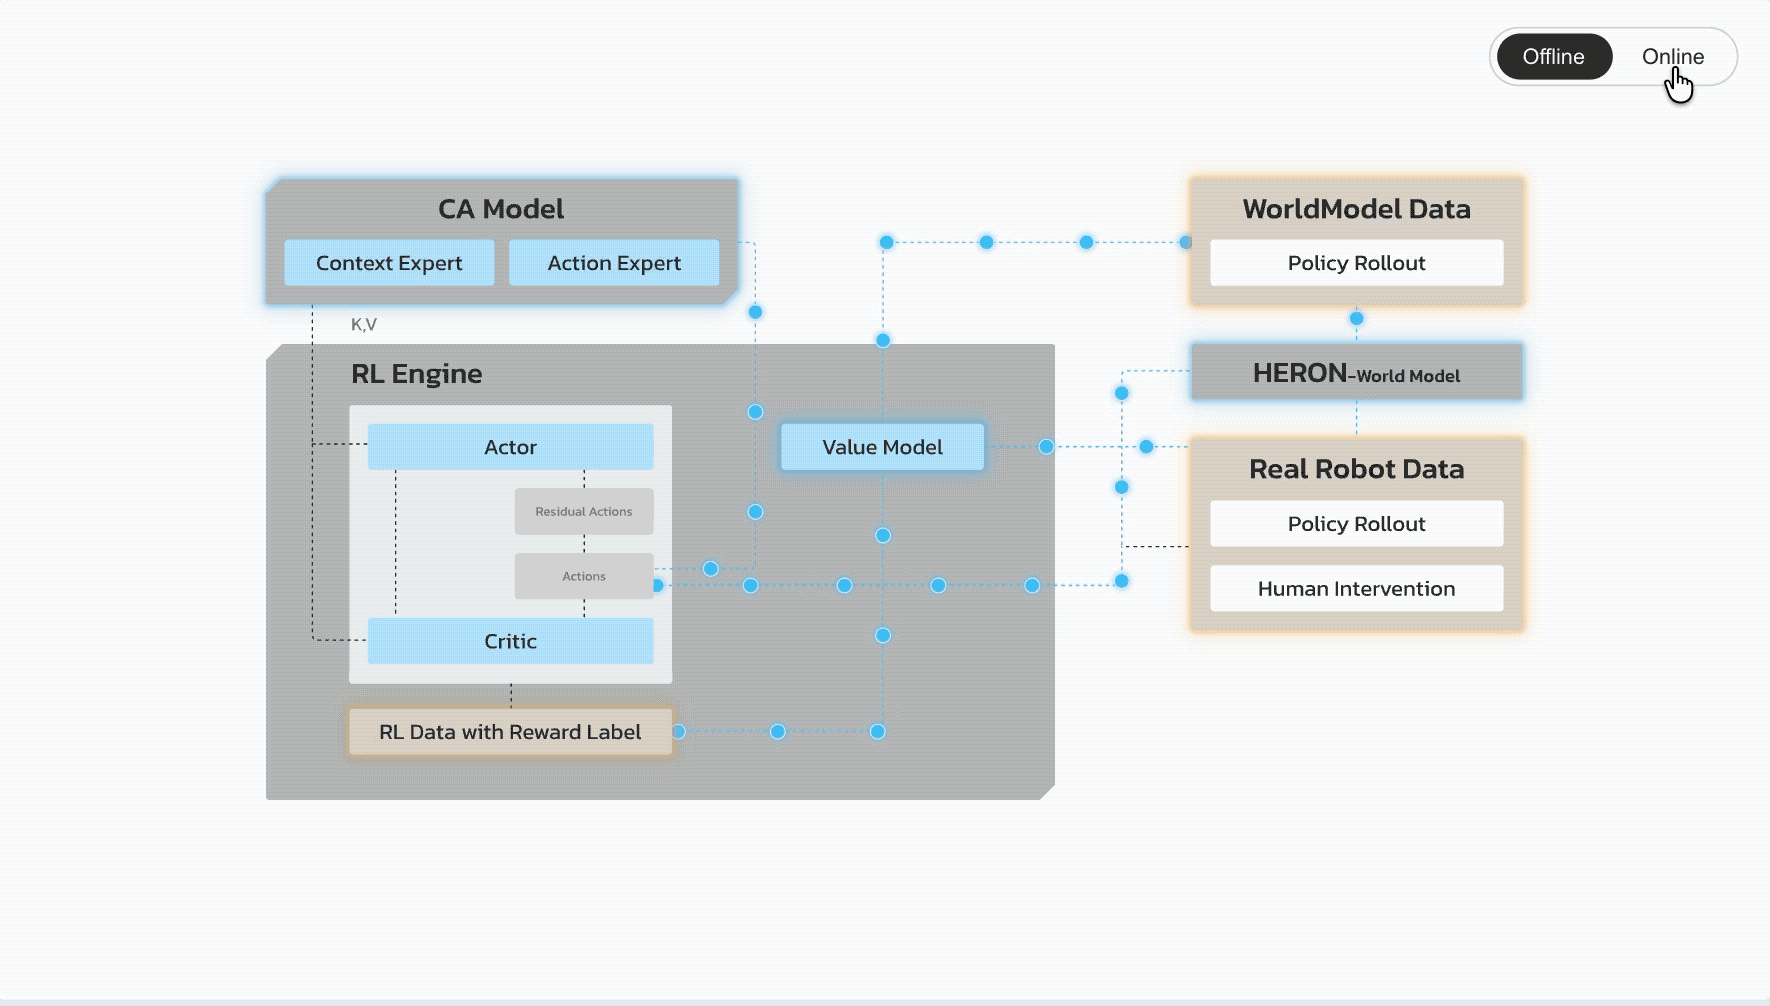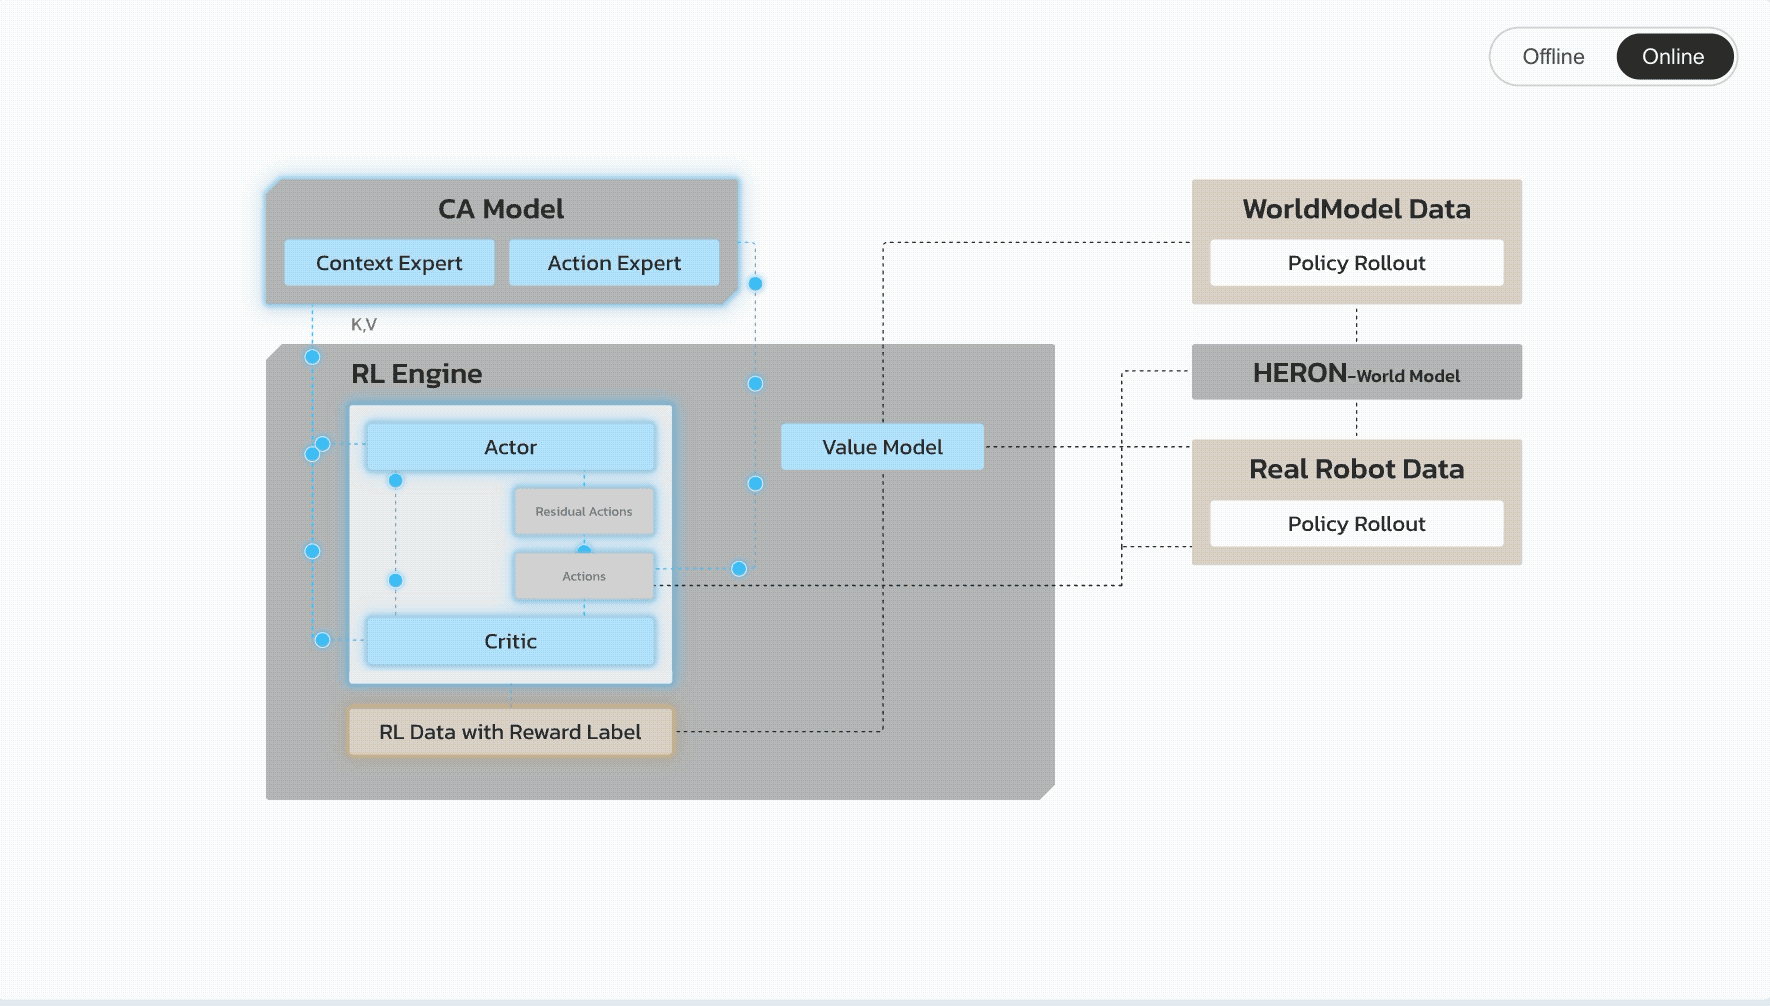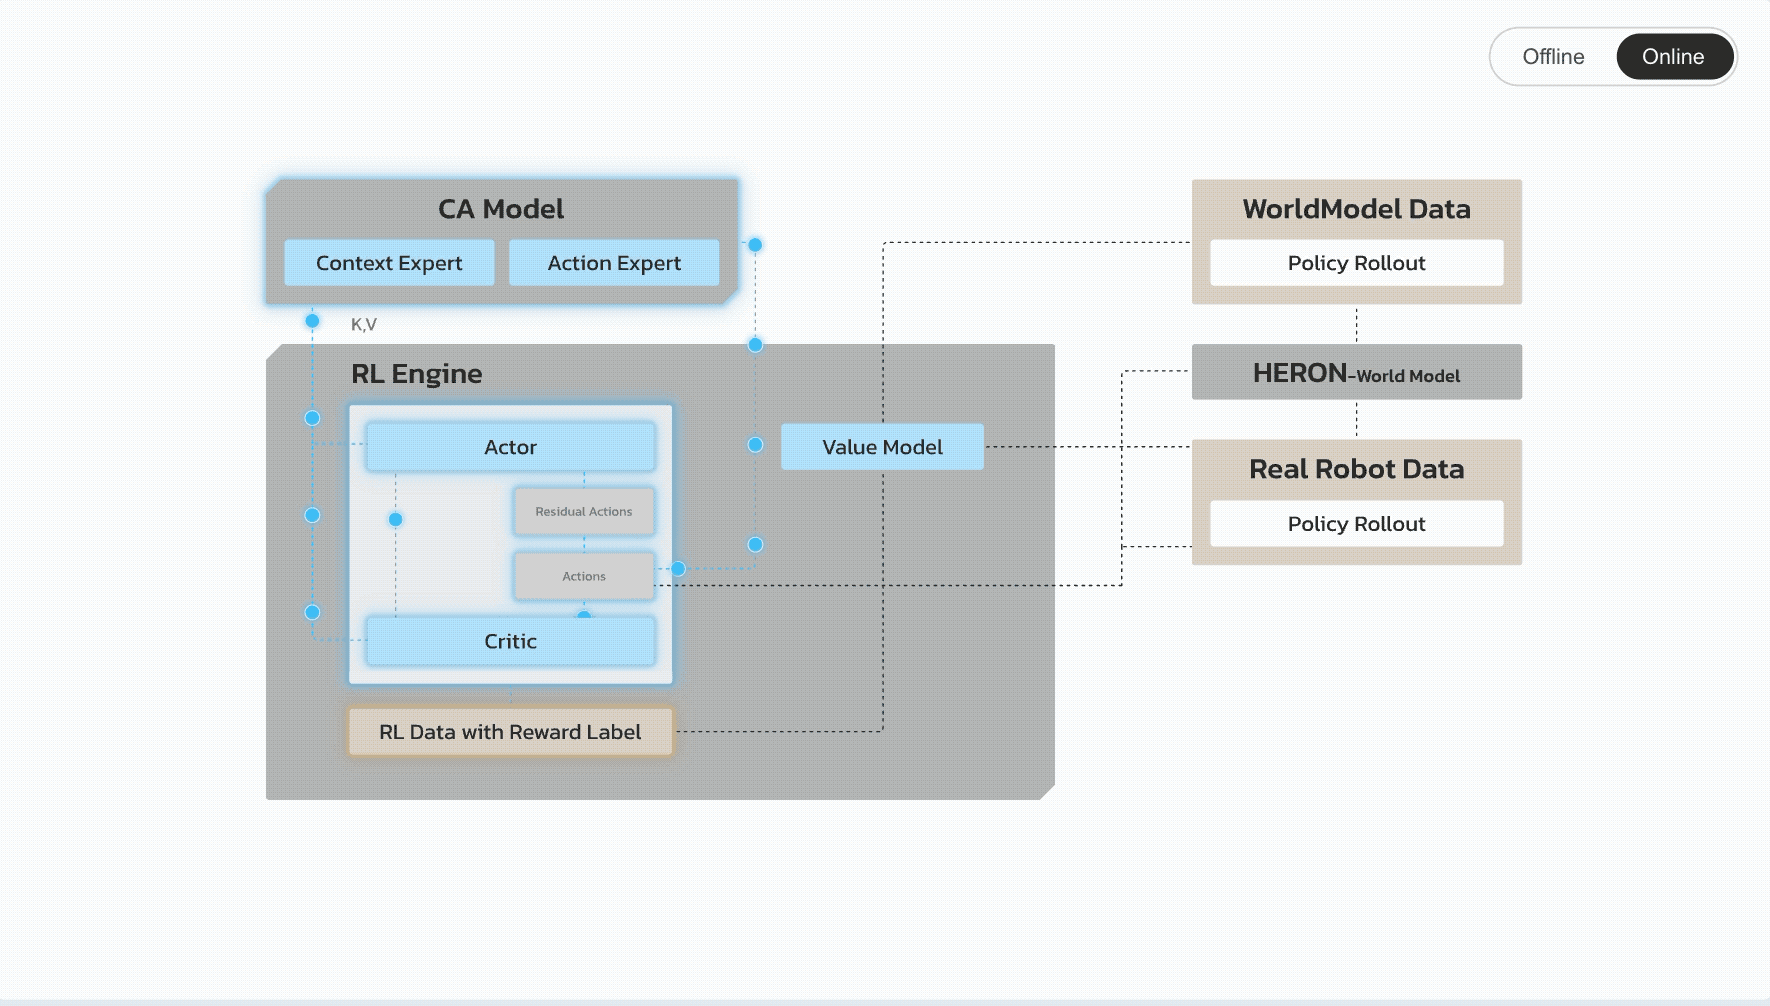
RL Engine还可以用同一套组件支持离线学习与在线学习。
如图所示,该引擎采用Actor-Critic架构,通过交叉注意力复用冻结的高信息密度多模态Context Expert的KV值:Actor预测动作残差,用于修正Action Expert的输出;Critic评估动作价值,以指导Actor的更新。训练全程仅更新Actor-Critic,其余模块保持冻结。
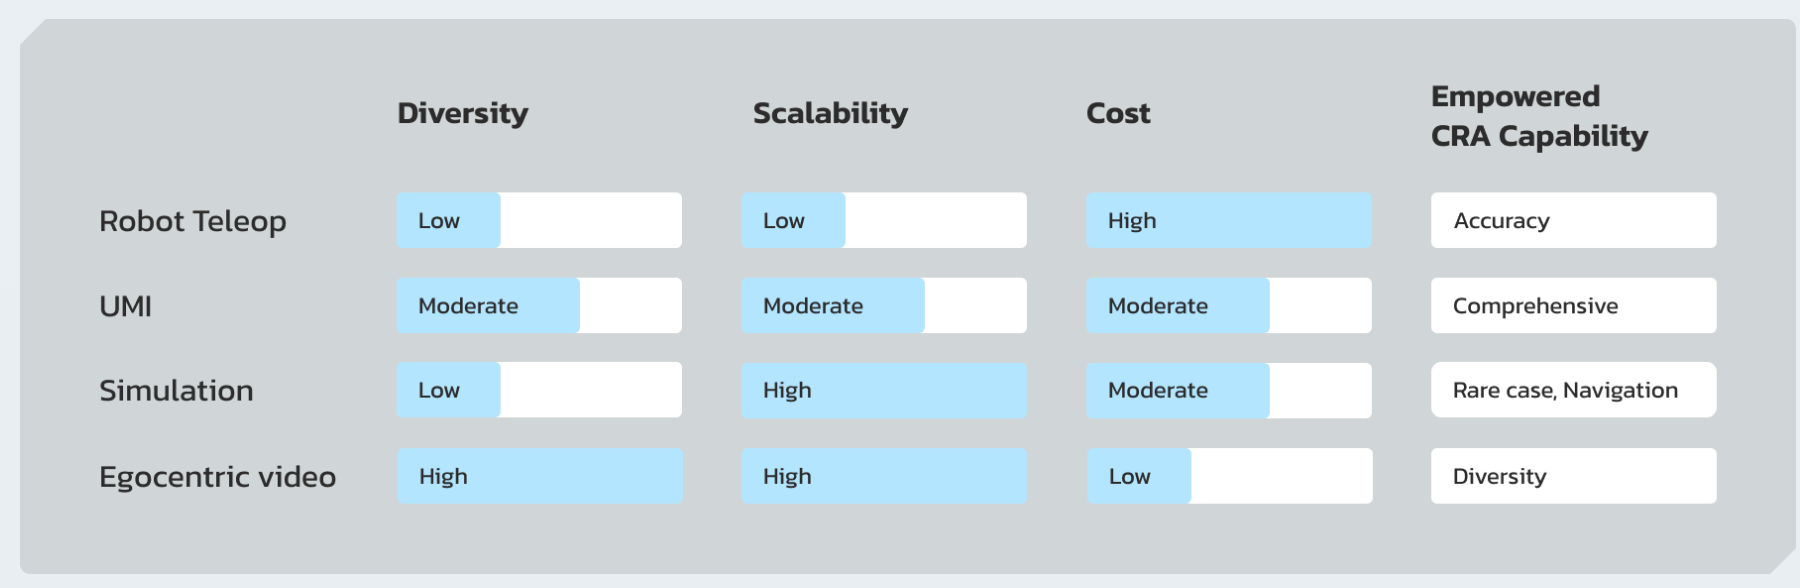
而在预训练数据上,松延动力认为,机器人数据来源不可避免要在多个维度之间做出权衡。
至于预训练阶段的目标,松延动力主张让基座模型学会的是对物理世界的理解,而非动作的执行,监督信号应当是真实的物理规律,而非仅有机械臂关节角度、末端位姿这类低维信号。
为此,在预训练过程中,其采用学习时空物理规律的方法,以物理规律为目标对模型进行监督学习,让模型在物理世界中建立起认知,同时联合监督机器人动作信号。
松延动力还透露了下一步计划,将在预训练模型之上进一步验证以下内容:
第一,检验预训练是否进一步提升了In-Context Learning与few-shot能力;同时,RL Engine兼具的Test-Time-Training(TTT)功能也将同步开展测试。
第二,聚焦预训练模型的落地应用:将模型部署到真实世界,把速度与成功率推高。
此外,松延动力指出,HERON-CRA与HERON-World Model目前主要聚焦上肢操作,后续将探索把HERON系列扩展至人形机器人的全身操作能力。
结语:组合有效,但下一步是走向现实场景
HERON-CRA的思路,是把”记住过去、从错误中学”拆成三个可组合的模块:跨本体预训练打底,Context Expert管记忆,RL Engine管纠错。
从演示看,这套组合是有效的:“蒙眼”抓物、猜球、单次示范学习都成功了,叠袜子成功率也从38.5%提升至97.8%。
但官方视频也留下了问号:机械臂操作不稳、切段不均、叠袜耗时一分多钟,跨本体的效果更多是“能完成”而非“完成得好”。
记忆和纠错的价值终究要回到真实场景里检验,这正是松延动力自己列出的下一步,也是这篇技术博客还没回答的部分。
成为付费用户可以阅读 松延动力 所有资料
了解更多 →