你擦桌子的動作,正在被機器人按分鐘收購。
普通人的日常動作,正在變成機器人最稀缺的養料。
8月底,美國機器人公司Figure幹了一件讓很多人愣一下的事:他們正式上線了一款手機app。
玩法很簡單。你打開app,選一個任務——擦桌子、疊衣服、切菜、整理貨架——然後把手機架在第一視角,錄下你幹活的全過程。上傳,Figure按視訊質量和時長給你付錢。
聽起來像個兼職app?但數字不太像。
隱身測試四個月,這款app覆蓋了108個國家,下載26.4萬次,周活4.4萬人,攢下了1600萬條視訊。Figure已經向這些"錄視訊的人"支付了1500萬美元。CEO Brett Adcock直接放話:未來12個月,要在資料和算力上砸超過10億美元。
10億美元買什麼?買全世界普通人幹活的視訊。
這件事荒誕嗎?仔細想,一點都不荒誕。它只是把一個行業裡藏了很久的秘密,擺到了檯面上:機器人最缺的不是晶片,不是演算法,而是你每天都在做、但從來沒覺得值錢的那些動作。
而圍繞"怎麼把人類動作變成機器人能吃的資料",一場安靜但兇猛的基礎設施競賽,已經開打了。
要理解為什麼Figure要花10億美元買家務視訊,得先理解具身智能現在卡在那。
過去兩年,VLA(視覺-語言-動作)模型成了機器人圈的共識路線。簡單說,就是讓機器人像大模型理解文字一樣,理解"看到的畫面+語言指令+該做的動作"之間的關係。GPT能寫文章,是因為網際網路上有兆級文字;但機器人要學會疊衣服,網際網路上沒有現成的"疊衣服動作資料"給它吃。
這就是行業說的"資料荒"。
舊的解法有兩種,都有硬傷。
第一種是遙操作。工程師戴著裝置,遠端操控機器人做動作,機器人一邊做一邊記錄。問題是貴、慢、假。一台機器人本體幾十萬,一個熟練操作員一天能采的資料量有限,而且操作環境往往是實驗室,不是真實的廚房和倉庫。有行業測算,遙操作採集一小時高品質資料的成本,是普通人自然錄製的上百倍。
第二種是扒網路影片。YouTube、抖音上確實有海量第一視角視訊,但問題是:這些視訊沒有動作標籤,手的精確軌跡、力度、物體空間關係全都對不齊。VLA模型要的不是"看一個人疊衣服",而是"每一秒手指在那個坐標、用了多大勁、衣服怎麼變形"。網路影片給不了這些。
所以Figure的邏輯很直接:既然實驗室采不起、網路影片用不了,那就把採集工具交到全世界人手裡,讓真實場景裡的真實動作,自己長出來。
這不是Figure一家的想法。幾乎在同一時間,中國的玩家們用完全不同的方式,衝進了同一個戰場。
如果把"採集人類動作資料"當成一個新行業,目前至少有三種打法。
第一種,Figure式:手機app + 全球眾包。
最輕的模式。不需要專用硬體,人人都有手機,任務平台化分發,按質付費。優勢是擴張極快——四個月108個國家就是證明。劣勢也明顯:手機攝影機的精度有限,手部細節、力度資料採集不到,資料質量參差不齊,後期治理成本高。Figure敢這麼幹,是因為它賭的是"規模先碾壓質量,再用模型能力消化噪聲"。
第二種,京東式:集中採集場 + 社區滲透。
京東在江蘇宿遷建了一個4000平方米的具身智能資料採集中心,1:1還原了客廳、廚房、藥房、超市、物流倉庫等上百個真實場景。採集員戴著頭戴採集裝置,在這些場景裡正常幹活——擦電器、配藥、分揀快遞、縫紉。
京東的野心更大:計畫兩年內採集1000萬小時真實場景資料,發動內部10萬員工加外部最多50萬各行業人員參與。他們甚至在宿遷搞了全國第一個"資料採集社區",培訓寶媽、退休人員在家做家務的同時完成採集。
這條路的優勢是場景可控、資料質量高、裝置專業。劣勢是重資產、擴張慢,而且"復刻的真實場景"和真正的真實場景之間,永遠有一層隔膜。
第三種,覓蜂式:穿戴工具 + 無本體採集。
這是最值得單獨說的一條路,因為它既不自己建採集場,也不做app平台,而是做"賣鏟人"——把專業級採集工具做輕、做便宜,賣給任何想采資料的人。
覓蜂科技2026年2月才成立,6月硬體量產,9月就宣佈裝置下線2萬套、累計有效資料超100萬小時。這個速度在硬體公司裡幾乎是離譜的。
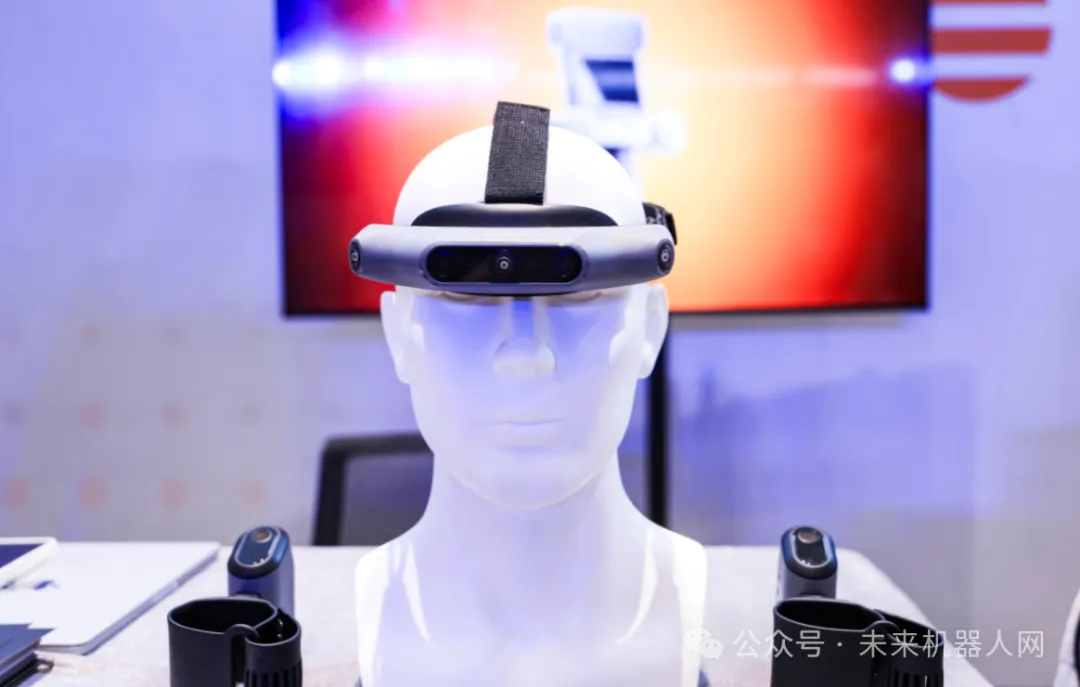
它的核心產品叫MEgo,分兩件:MEgo Gripper是一個戴在手上的二指夾爪,能毫米級還原手部軌跡和力度;MEgo View是頭戴+腕部雙視角攝影機,記錄第一視角和手部特寫。人戴上它,該洗碗洗碗,該配餐配餐,工具在後台把動作、空間、觸覺、聲音全部記下來。
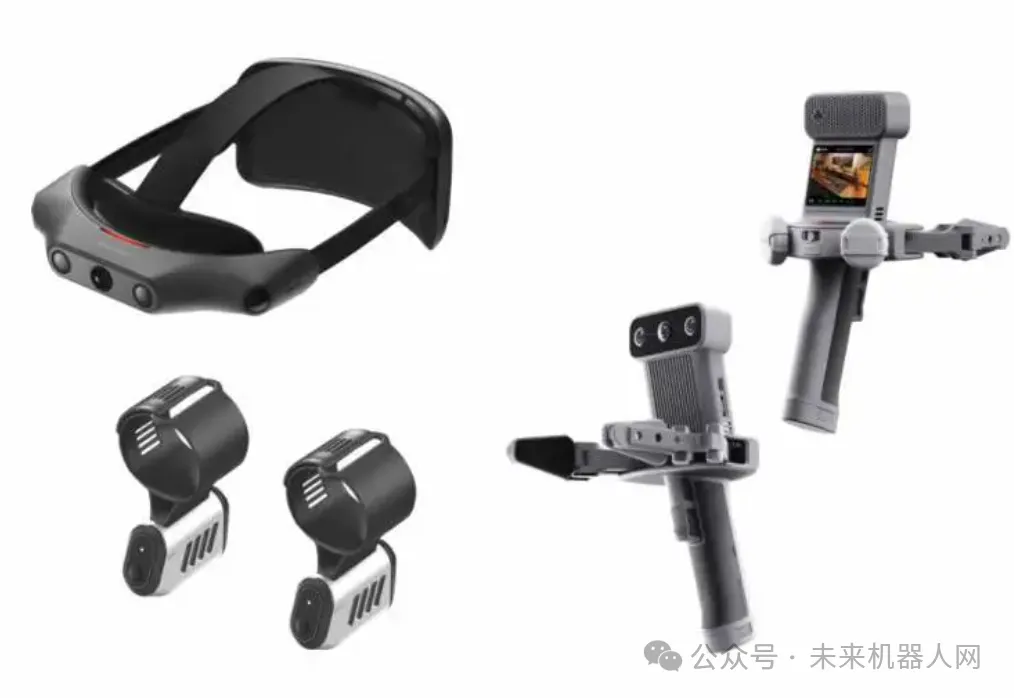
關鍵概念叫"無本體"——不需要機器人本體在場,人就是採集本體。人的勞動原本就會發生,MEgo負責把其中有價值的部分數位化。
覓蜂的採集效率比傳統遙操作提升了5倍,原因很簡單:遙操作是"一個人專門操控一台機器人演戲",MEgo是"一個人正常幹活,工具順便記錄"。後者的邊際成本趨近於零。
現在,覓蜂已經和騰訊Robotics X實驗室簽了合作,裝置進了工廠、物流、商超、家居、康養等場景。退休人員、寶媽、家政阿姨,正在變成這個新行業的一線"資料工人"。八大頭部場景貢獻了約82%的資料,剩下的長尾場景在持續拓展覆蓋。
這家公司半年就拿了數億元融資,國方創投領投。資本不是傻子——它們看到的不是一家硬體公司,而是具身智能時代的"資料電網"。
把這三條線放在一起看,一個更大的趨勢浮出水面:"個人蒸餾"正在從概念變成真實工種。
什麼叫個人蒸餾?就是把一個人在長期勞動中積累的隱性技能——怎麼拿刀最穩、怎麼打包最快、怎麼把衣服疊成方塊——通過採集工具提取出來,轉化成機器人可以學習的結構化資料。
過去,這些技能只在你自己的身體裡。你會疊衣服,但你沒法把"會疊衣服"這件事單獨拿出來賣。現在可以了。戴上裝置,幹一遍活,你的肌肉記憶就變成了一段可以被定價、被交易、被訓練模型的資料。
這不是比喻。京東宿遷的採集社區裡,寶媽邊做家務邊拿補貼;Figure的app上,有人靠錄家務視訊獲得收入;覓蜂的裝置進了家政公司,阿姨的每一次擦拭和整理都在產生資料資產。
人類勞動的價值,正在被重新定價。
以前我們說"AI替代人",焦慮的是崗位消失。但這一波資料採集潮講的是另一個故事:在機器人真正能替代人之前,它先要大規模地"需要人"——需要人教它怎麼幹活。而教的方式,不是寫說明書,是把你的動作錄下來,喂給它。
這個判斷有幾個延伸含義:
第一,資料採集工具會成為比機器人本體更早爆發的賽道。機器人還在實驗室裡迭代,但採集工具已經開始進家庭、進倉庫、進工廠。淘金熱裡,賣鏟子的往往先賺錢。
第二,最終勝出的不是資料量最大的,而是單位資料成本最低的。Figure賭規模,京東賭質量,覓蜂賭工具——三條路線最終會在"每小時有效資料的成本"這個指標上交匯。誰能把採集成本壓到最低,誰就掌握定價權。
第三,普通人的"身體經驗"第一次變成了可流通的商品。這意味著新的就業形態,也意味著新的問題:資料歸誰?定價誰說了算?隱私邊界在那?這些問題現在沒人有答案,但它們一定會來。
當然,這個判斷也有邊界。
目前的個人蒸餾還處在非常早期的階段。採集裝置的精度、資料治理的標準化、不同場景之間的通用性,都遠未成熟。Figure的1600萬條視訊裡,真正能直接用於VLA訓練的比例有多少,行業裡還有爭議。京東的1000萬小時目標能不能按期完成,也要打個問號。覓蜂的2萬套裝置,更多還是B端客戶在買單,C端普及還沒開始。
更穩妥的說法是:我們正在見證一個新基礎設施的"通電時刻"。燈還沒全亮,但電網已經在鋪了。
Figure花10億美元買的,不是視訊。是人類用了幾百萬年進化出來的、那雙靈巧的手和那個知道怎麼幹活的大腦。
而我們每個人,可能都還沒意識到自己身上藏著多少可以被"蒸餾"出來的價值。 (未來機器人網)
成为付费用户可以阅读 腾讯 所有资料
了解更多 →