过去三年,语言模型和 agent 的能力飞速提升。很多人把功劳归给了更大的模型和更多的数据——这当然没错,但如果只是规模的问题,为什么 code agent 的进步会比其他任务快那么多?
答案藏在一个结构性优势里:代码是可以自我验证的。具身智能要走同样的路,但机器人世界缺少这套基础设施。
RL 闭环,改变了后训练的逻辑
大规模预训练给了模型基础能力,但让模型真正学会做事的,是后训练阶段的反馈闭环——code agent 的快速进步正是这个机制的体现。代码可以被执行,测试可以判定正误,失败轨迹直接沉淀为训练信号:反馈高频、验证明确、数据可回流。RL 和偏好学习之所以在 code agent 上格外有效,正是因为有这套自闭环基础设施在支撑,而非仅仅因为模型规模更大。
具身智能需要同样的闭环机制。一个 VLA 模型不应该只学会在数据集里复现专家动作,它需要能够尝试动作、观察后果、判断任务是否更接近成功,并把这些反馈变成学习信号。但在机器人这里,没有这样一套天然的验证基础设施——没有可以运行的测试,没有判定对错的即时反馈,每一次失败的代价都是真实的物理代价。
VLA 的闭环飞轮为什么转不起来
VLA 的输出是真实世界里的物理动作:每一步都会改变物体位置、接触关系和任务的可恢复性,每一次失败都需要人工复位,每一次尝试都有真实的时间与硬件代价。
真机 rollout 的成本是根本性障碍。 机器人速度慢,设备、场地与维护成本高,大量失败尝试还可能损坏硬件——规模因此难以扩大。人工反馈效率低,且很多时候给不出机器能直接用的信号。 机器人任务的反馈往往是细粒度的中间状态判断("当前偏差是否还能恢复"),让人类持续标注这类信号,成本极高。传统仿真有 sim-real gap,而且这个 gap 在日常操作任务上格外难弥合。 透明反光物体、柔性形变、真实接触噪声、家庭场景的长尾分布——仿真很难还原,用它训练出的策略在真机上往往脆弱。
VLA 需要一种新的闭环方式:比真机便宜,比人工反馈高频,比传统仿真更贴近真实物理。这就是世界模型的定位——不是一个生成视频的模块,而是 VLA 后训练中的 learned environment。
解法:世界模型作为 VLA 训练环境
VLA 的世界模型需要回答三个核心问题:
- 给定当前状态和候选动作,世界会如何变化?
- 这个变化是让任务更接近成功,还是正在偏离?
- 这些成功、失败、偏离的信号,能否持续变成 VLA 的训练数据?
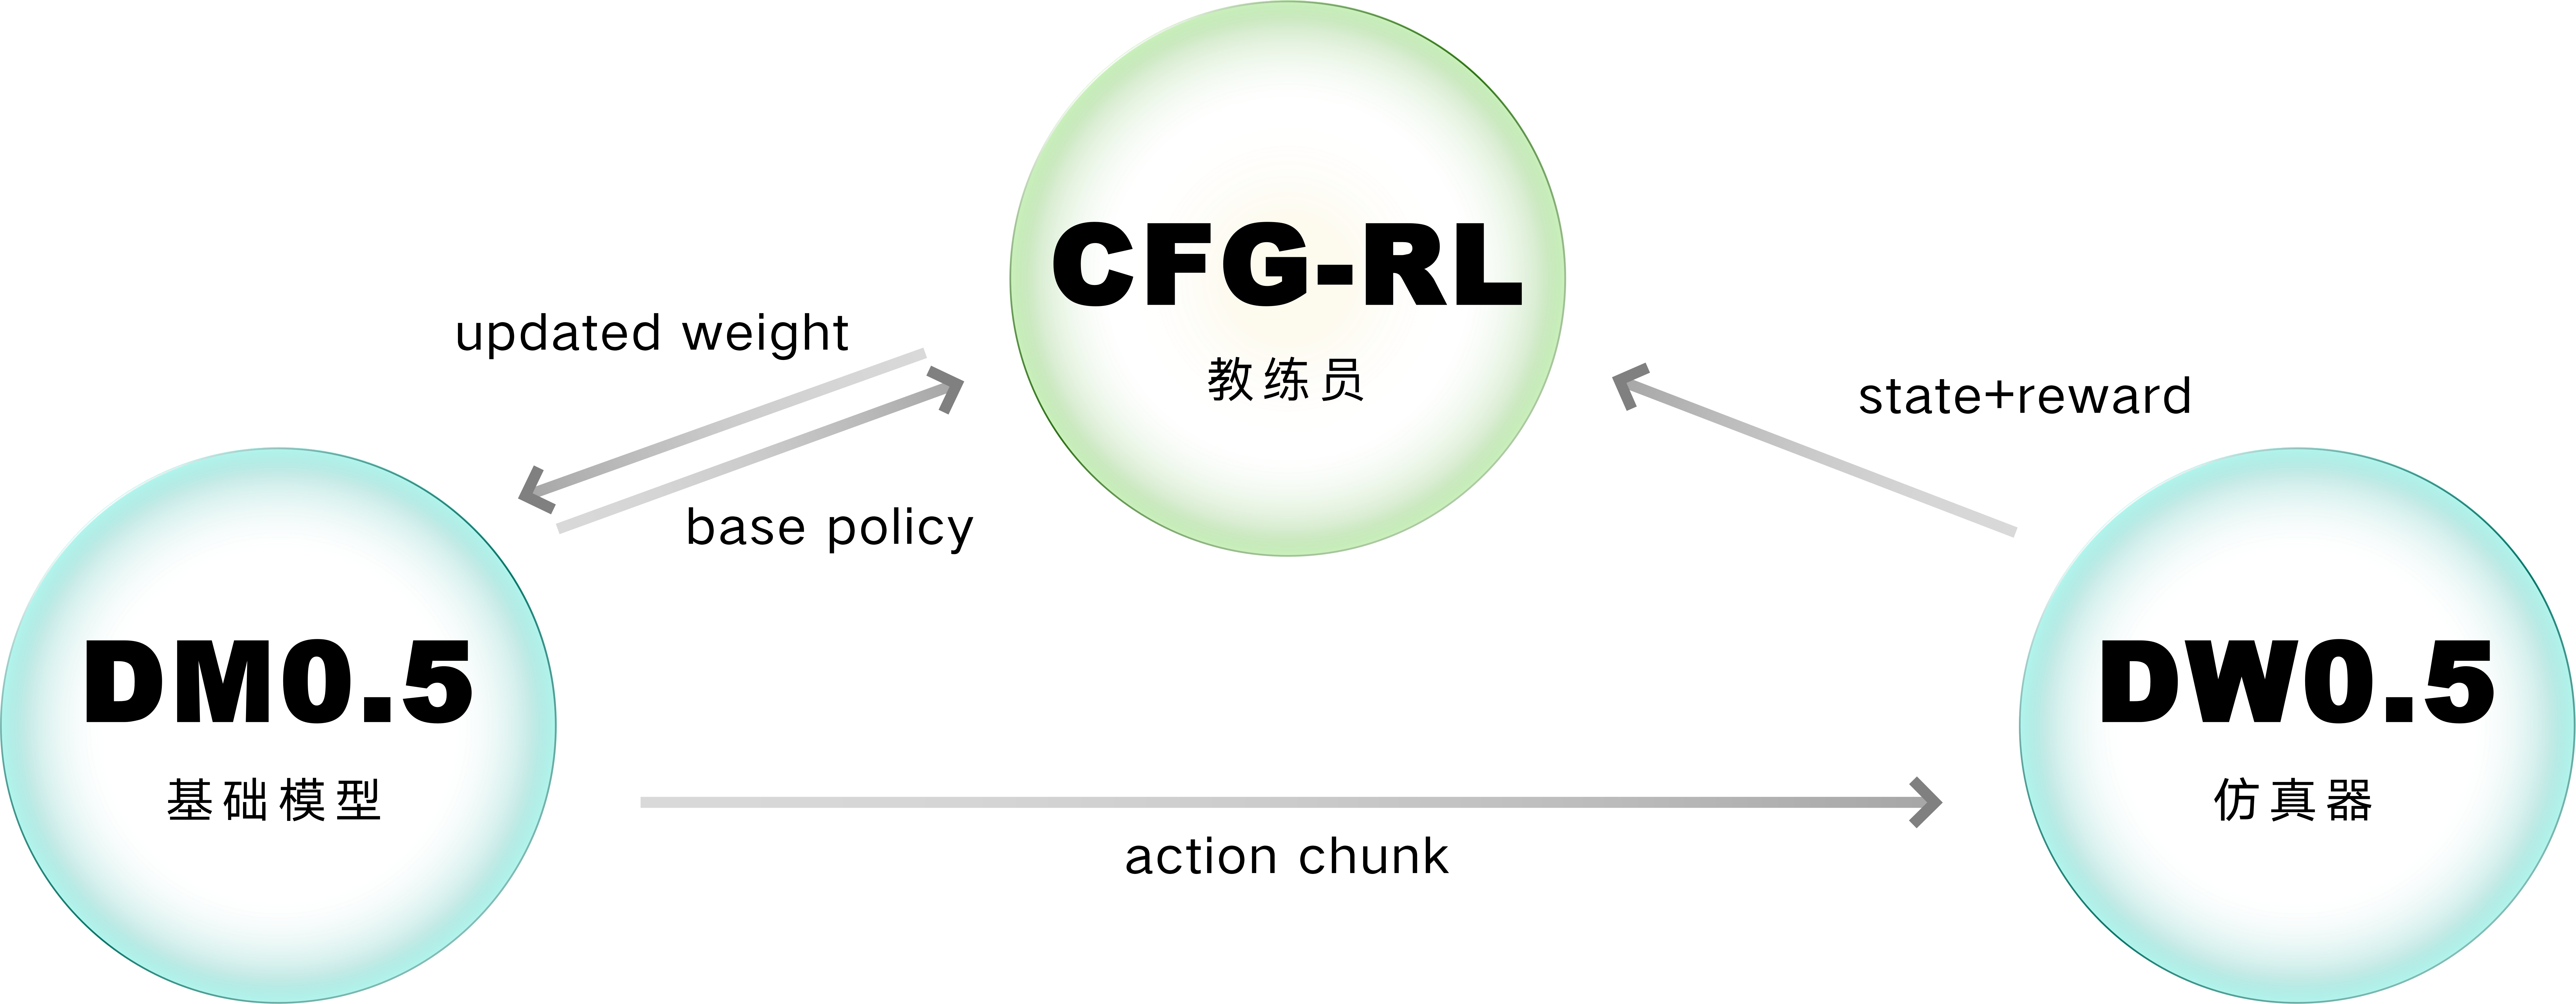
DW0.5 围绕这三个问题设计。它不是只追求视觉真实感的视频生成模型,也不是直接从图像和语言回归动作的策略模型。我们希望 DW0.5 成为 VLA 闭环迭代的训练环境:VLA 产生候选动作,DW0.5 模拟动作后果,Value Expert 给出价值反馈,训练系统用这些反馈做策略筛选、数据构造或 RL 后训练。
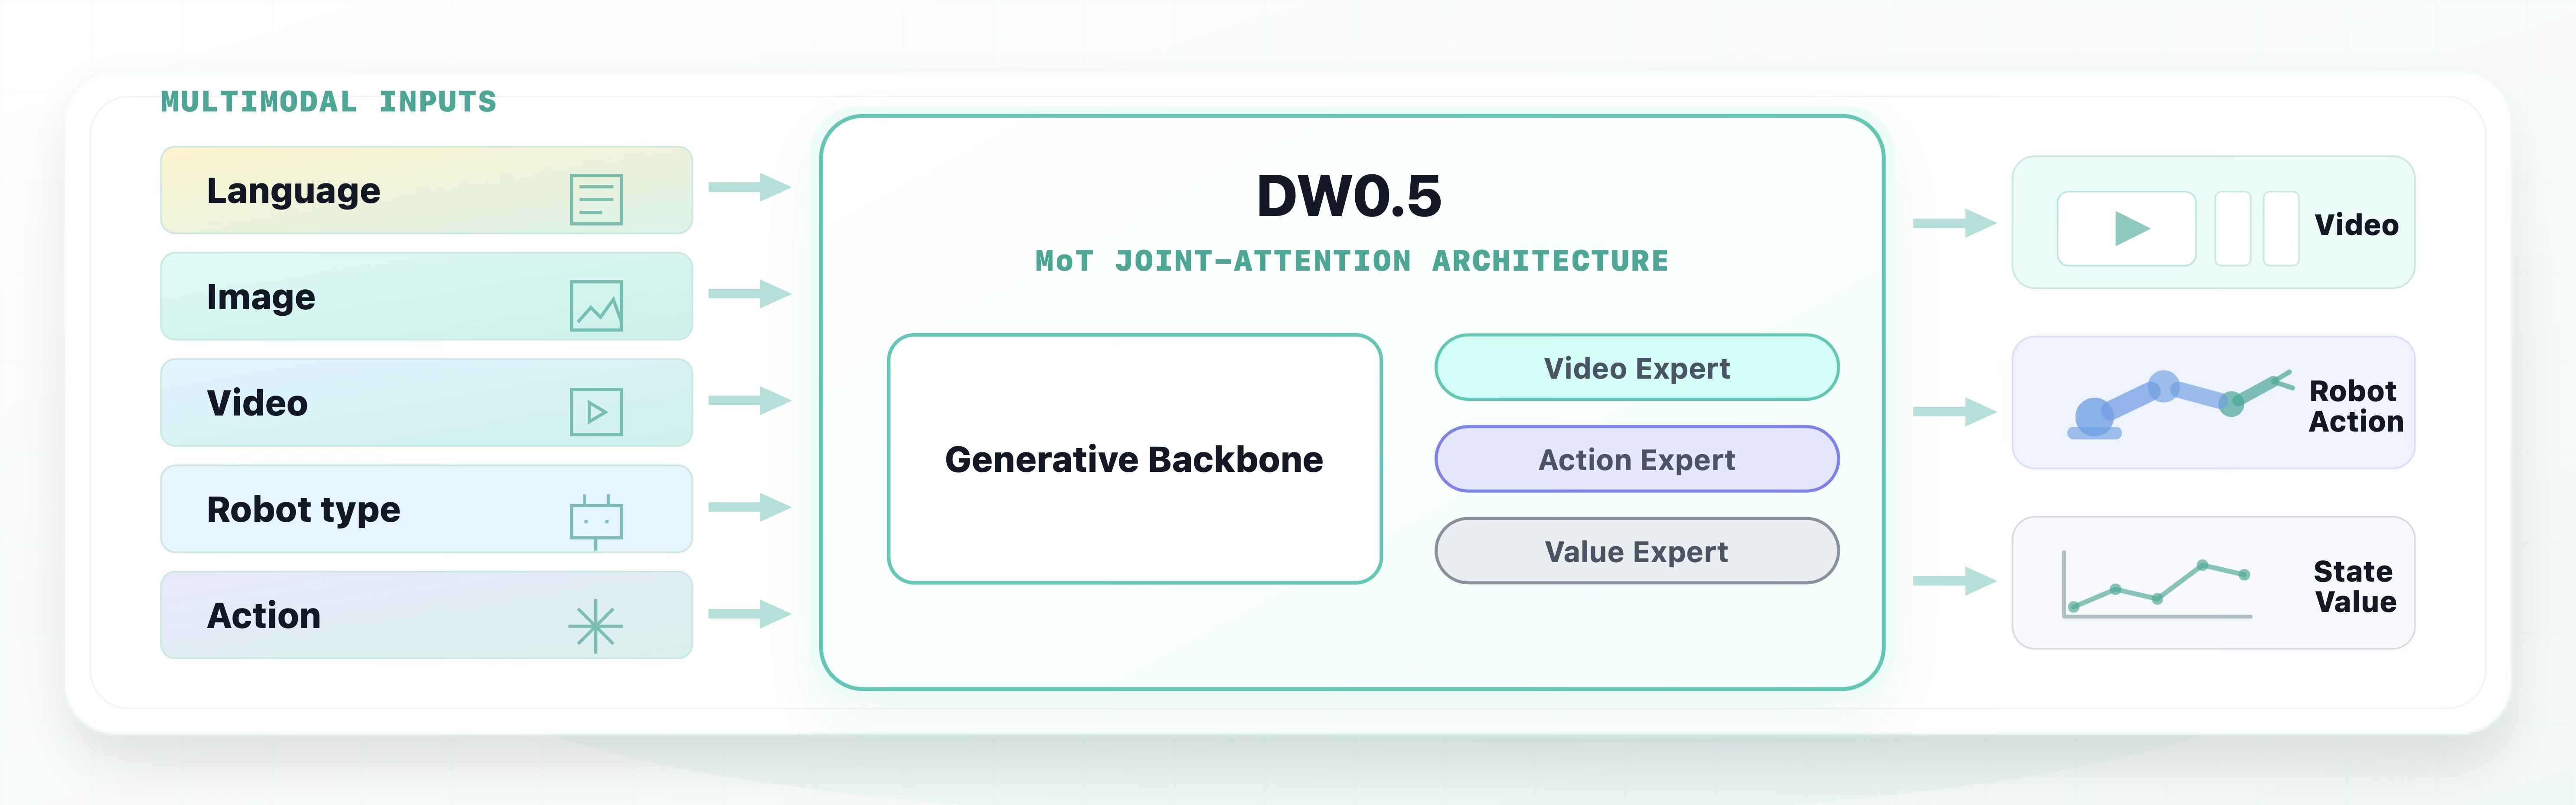
这个闭环可以概括为:
- VLA 根据语言指令、当前观察和机器人状态采样候选动作
- DW0.5 在动作条件下生成对应的未来视觉 rollout
- Value Expert 对当前状态、候选未来或整段 rollout 给出成功概率或任务价值评分
- 系统根据这些反馈选择动作、构造偏好数据,或对 VLA 做 RL 后训练
- 少量真机 rollout 持续校准世界模型,让闭环不断贴近真实部署分布
真实机器人不会消失——它是飞轮的起点,而不是唯一的训练场所。真实 rollout 校准世界模型,世界模型支持低成本大规模探索,新的策略再回到真实环境验证和收集数据。
为了让这个闭环真正能跑起来,DW0.5 有三个核心设计。
设计一:Action 是强先验,而不是软提示
世界模型能不能成为 VLA 的训练环境,有一个最基本的测试:给定同样的起始状态,不同的动作,是否生成了不同的未来?
如果向左推和向右推的 rollout 看起来差不多,这个"世界模型"就只是一个带成功偏置的视频生成器,对 VLA 训练毫无价值。这就是动作条件建模的核心挑战。
将动作映射到语言空间是一种常见做法:把连续动作序列离散化为 token,纳入语言模型的词表,作为视频生成的条件输入。这种方式实现简洁,但有两个根本性的局限。
第一,这是软约束。动作 token 进入语言空间后,与视频 token 的关系等同于普通的语义引导——模型可以参考它,也可以在生成视觉上连贯的画面时选择性地弱化它。给定一个将物体推偏的失败动作,模型仍然可能生成一段看起来顺利完成的过程。对于需要精确响应不同动作的训练环境来说,这样的约束力远远不够。
第二,动作与视频帧之间没有时序对齐。动作序列在物理上对应的是逐帧的执行指令,但映射到语言空间后,这种帧级对应关系就丢失了——模型无法知道第 3 帧的末端执行器应该在哪里,夹爪闭合对应的是第几帧,接触力在哪一时刻发生。缺少帧级对齐,动作对视频生成的影响只能停留在整体语义层面,无法精确传导到每一帧的物理状态。
图像条件(如末端轨迹投影、ray map 或像素空间引导)比文本更接近控制,但引入了新的依赖:这类方法通常需要精确的相机内外参、机器人几何模型和坐标系标定——任何相机变动、末端工具更换或数据来源切换都需要重新适配,泛用性很差。更根本的问题是,像素投影并不等价于真实动作语义。它无法表达关节角度变化、夹爪开合时序、多自由度耦合运动,以及同一动作在不同视角下的空间含义。
DW0.5 的选择是:把 action 当作视频生成的一等条件,通过结构化的帧级对齐强制绑定。在 MoT(Mixture of Tokens)自注意力中,动作序列与视频序列拼接在同一个 token 序列里,并通过 group-diagonal attention mask 实现精确的帧级约束:第 i 帧的视频 token 只能 attend 第 i 组动作 token,而不是全局共享所有动作信息。这不是权重层面的软引导——attention mask 从结构上切断了视频帧与非对应动作之间的信息通路。执行向左推的动作序列,和执行向右推的序列,在模型内部从一开始就走向完全不同的计算路径,产生不同的未来。
这个设计服务于一个明确目标:VLA 采样多个候选动作,DW0.5 对每个动作独立 rollout 出不同未来,Value Expert 再对这些未来打分。只有当世界模型真的对不同动作给出不同响应,它才能成为 VLA 探索策略空间的训练环境。
设计二:模拟成功与失败,让世界模型成为真正的仿真器
如果世界模型要成为训练环境,它必须学会模拟失败。
这一点听起来顺理成章,但影响深远。如果训练数据只有专家成功轨迹,模型会形成过强的成功先验——无论给什么动作,它都倾向于生成任务完成的画面。这样的模型没有办法告诉 VLA 某个动作会把物体推到难以恢复的位置,没有办法惩罚错误行为,也没有办法用于 RL 后训练。它展示的只是"成功是什么样的",而不是"给定这个动作,后果是什么"——这是视频生成模型,不是仿真器。
具身公开数据与自采机器人数据,提供多任务、多平台、多视角的机器人操作经验。自采数据在统一传感器配置下记录真实执行过程,包含遮挡、接触、延迟、抖动和误差累积——这些是真机部署中实际存在的噪声,不是仿真里的理想化轨迹。
互联网视频数据,补充开放世界的视觉动态。机器人数据很难覆盖所有物体、场景和事件变化,互联网视频提供更丰富的视觉外观、空间布局和日常动态,让 Video Expert 不局限在窄分布的机器人实验室画面里。
Egocentric 数据,是这个数据体系里容易被低估的一类。第一视角人类活动包含大量真实物体交互:拿取、放置、打开、形变、滑动、倾倒,以及失败后的修正动作。人的动作空间和机器人不同,但物体在真实世界里的视觉后果和物理规律具有可迁移性。Ego 数据让模型接触到更广泛、更密集的现实物理交互,而不只是狭窄分布的实验室场景——这对于 Video Expert 准确模拟接触后果、物体运动趋势和形变规律至关重要。
真机与仿真 rollout 数据,是让 DW0.5 成为真正仿真器的关键。我们同时使用正常采集和真机实验中产生的成功、失败轨迹,并结合仿真环境中的大规模 rollout,覆盖偏离、卡住、恢复等多种中间状态;此外,还引入了 RoboChallenge 的真实成功与失败数据,作为额外的真实成败案例补充。仿真 rollout 可以高效探索更大的动作空间和失败边界,真机 rollout 则提供真实接触噪声、执行误差和长尾场景。两者结合,让 DW0.5 不只学习"应该怎么做",也学习"如果做错了,世界会变成什么样"。
世界模型能模拟失败,是 VLA 后训练能够使用 RL 的前提。没有这个能力,就没有可以优化的 reward 信号。
下面展示 DW0.5 在相同任务上生成的成功与失败轨迹对比:
设计三:Value Expert 把未来变成可训练的反馈
有了动作强条件和覆盖失败的 rollout,世界模型已经能告诉 VLA"如果执行这个动作,未来会是什么样"。但这还不够——VLA 的 RL 后训练需要 reward,需要知道哪些动作值得强化,哪些动作应该被抑制。
机器人任务的 reward 往往极度稀疏:通常只有任务彻底完成时,才能确认成功或失败。但很多失败在中间状态里已经有了明确征兆——物体姿态逐渐偏离目标、夹爪接触点不稳、目标被推到难以恢复的位置、动作把环境带入了低成功率区域。如果这些信号只能等到任务结束才反馈,训练效率会极低。
DW0.5 引入 Value Expert,就是为了把生成的未来转化为更密集的价值信号。 它对当前状态、候选轨迹或整段 rollout 给出成功概率或任务价值评估,将稀疏的任务结果信号转化为可以在每一步使用的中间反馈。
在闭环系统中,Value Expert 可以用于:
- 候选动作筛选:对多个 rollout 打分,让 VLA 选择更可能成功的未来
- RL 后训练的 reward 信号:在世界模型环境中对 VLA 做策略优化,无需频繁占用真机
- 部署时的在线监测:发现当前状态偏离成功路径,及时触发重新规划或失败恢复
Value Expert 是 DW0.5 从"视频世界模型"走向"训练环境"的关键一步。Video Expert 模拟动作后果,Value Expert 把后果转成可优化信号——两者结合,才构成完整的 RL 训练闭环。
三个设计,服务同一个闭环
把上述三个设计组合起来,DW0.5 在 VLA 的训练和部署中可以扮演三种角色:
离线数据增强与偏好构造。 VLA 从数据集学习专家动作的同时,使用 DW0.5 对候选动作进行未来 rollout 和价值评估,自动构造偏好对、失败样本和恢复样本,形成可持续的训练数据。
RL 后训练环境。 VLA 在 DW0.5 中采样动作序列,观察生成的未来视觉状态,并根据 Value Expert 的评分获得 reward 反馈,在不频繁占用真机的情况下进行低成本的大规模策略优化。
部署时规划与安全评估。 在执行之前,系统对多个候选动作进行短视野 rollout,选择价值更高、风险更低的动作;一旦 Value Expert 判断当前状态偏离成功路径,立即触发重新规划。
这个闭环的目标不是制造一个完美仿真器,而是让有限的真实机器人交互产生最大的训练价值:真实 rollout 校准世界模型,世界模型支持低成本大规模探索,新的策略再回到真实环境验证和收集数据。
## 指标表现
我们在三个互补 benchmark 上评估 DW0.5:EWMBench 和 WorldArena 侧重世界模型能力,RoboTwin2.0 侧重策略执行能力。DW0.5 在三项评测中均取得 SOTA,说明它不仅能生成可评估的未来 rollout,也具备稳定的动作输出能力。
世界模型评测
EWMBench 评估具身世界模型的生成质量,重点考察场景一致性、运动正确性和语义对齐。DW0.5 在 EWMBench 上以 4.66 的总分排名第一。
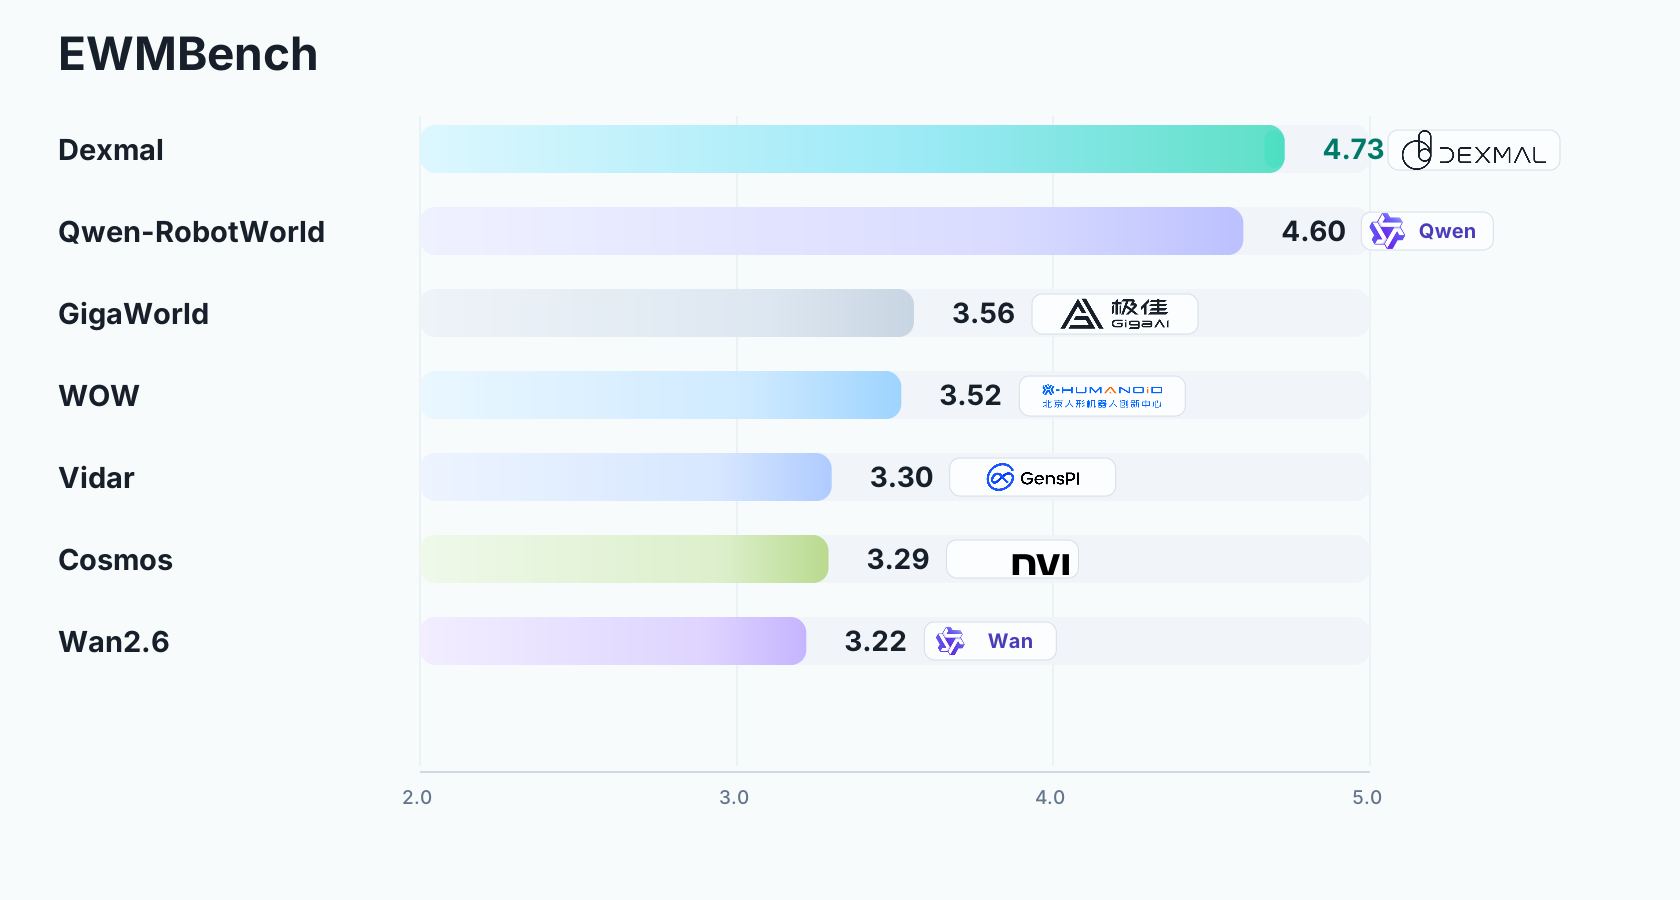
EWMBench 综合排名(截至 2026-07-09)
WorldArena 更关注开放世界交互动态和未来状态建模,衡量模型能否在复杂场景中预测合理的后续状态。DW0.5 在 WorldArena 上以 73.54 的分数排名第一。
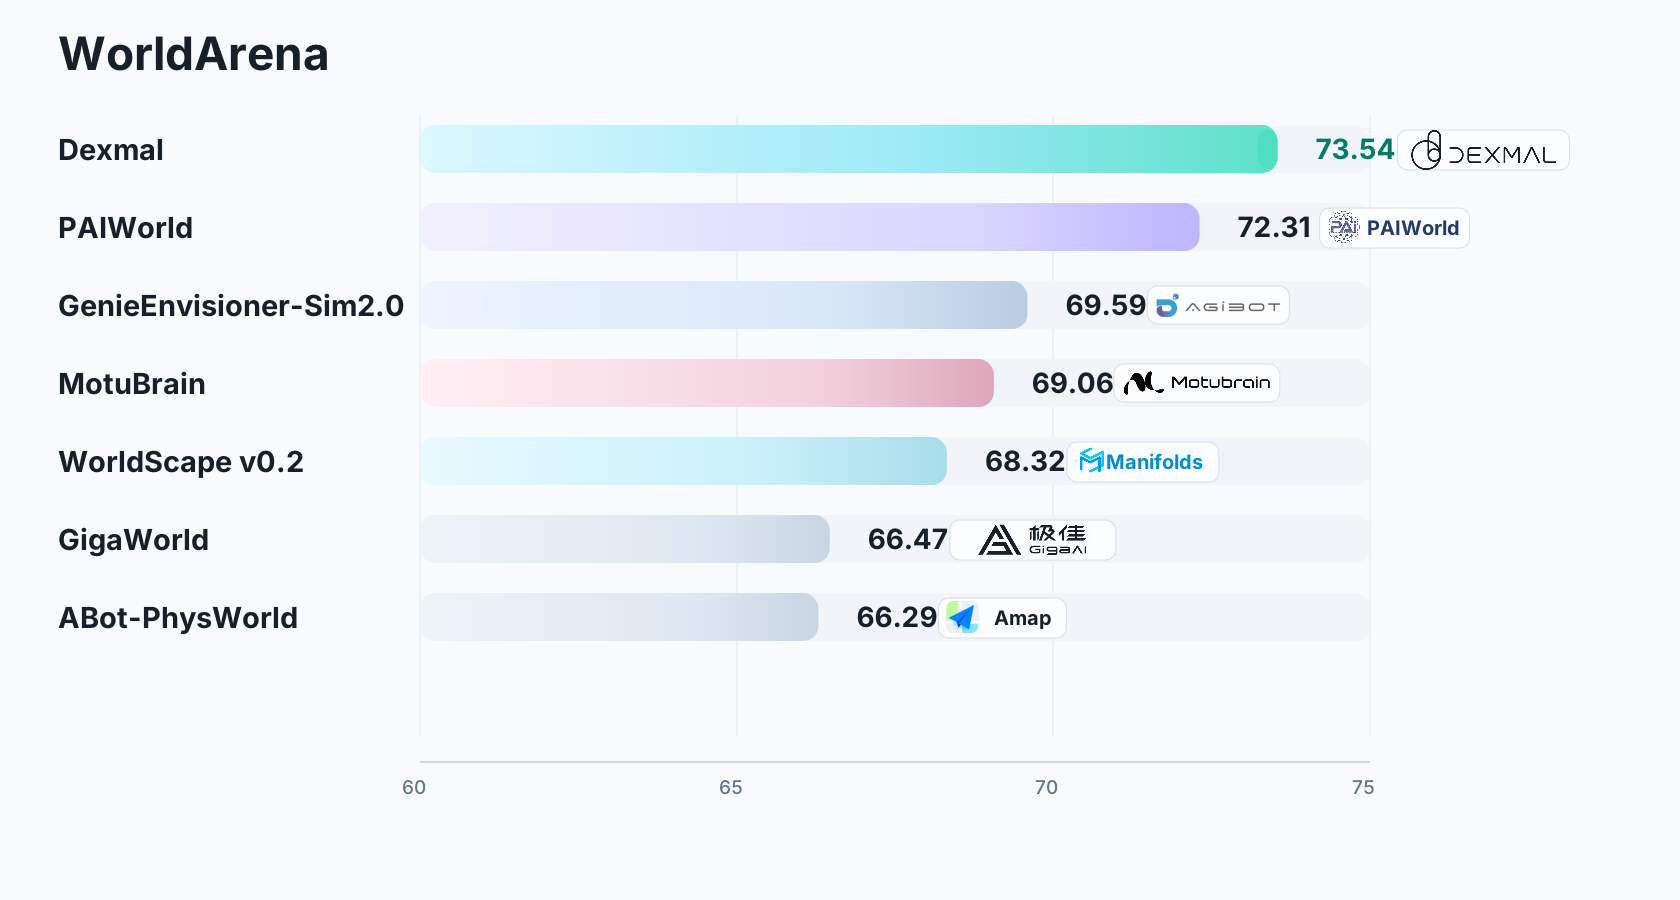
WorldArena 综合排名(截至 2026-07-09)
RoboTwin2.0
| Method | Clean | Randomized | Average |
| --- | --- | --- | --- |
| π 0 | 65.9 | 58.4 | 62.2 |
| π 0.5 | 82.7 | 76.8 | 79.8 |
| Motus | 88.7 | 87.0 | 87.9 |
| LingBot-VLA | 86.5 | 85.3 | 85.9 |
| LingBot-VA | 92.9 | 91.5 | 92.2 |
| ABot-M0 | 86.1 | 85.1 | 85.6 |
| StarVLA | 88.2 | 88.3 | 88.3 |
| Being-H0.7 | 90.2 | 89.6 | 89.9 |
| Qwen-VLA | 86.1 | 87.2 | 86.7 |
| FastWAM | 91.9 | 91.8 | 91.9 |
| DW0.5 | 93.3 | 93.3 | 93.3 |
DW0.5 在 clean 和 randomized 两种设置下均达到 93.3,平均分 93.3,取得 RoboTwin2.0 SOTA。RoboTwin2.0 直接评估双臂仿真环境中的动作策略能力,这一结果说明 Action Expert 在复杂操作任务和场景扰动下都具备稳定表现。
Demo
1. 跨环境、跨任务
2. 跨本体
3. 多视角一致性
4. 动作-视频生成一致性
每个示例中,左上为生成的视频,左下为初始祯,右侧为 action condition 可视化。
展望
下一阶段,让世界模型变得更通用仍是最重要的方向。现有结果说明,DW0.5 已具备跨任务、跨机器人和跨场景的基础泛化能力;在此基础上,更关键的是继续扩大对机器人形态、物体属性、接触模式和长尾环境的覆盖,并将这些差异沉淀到统一的世界表征中。只有当这种表征能够稳定迁移,世界模型才会从"能泛化到多类场景的 rollout 模型"走向更可复用的训练环境(learned environment)。
通用性提升之后,VLA 与世界模型之间的闭环也会变得更高效。当前的候选动作、未来 rollout 和价值评估链路已经形成雏形,但要支撑更复杂的任务,还需要让 VLA 采样、世界模型预测、Value Expert 评价和真机校准以更高频率协同。这样的闭环越顺畅,越能支持高成本、长时程、难复位的操作任务,也能让世界模型从离线数据增强扩展到策略探索、失败恢复和部署前验证等环节。
再往前看,RL 框架本身也需要更强的自闭环能力。今天很多机器人 RL 仍依赖 DAgger、人工标注或人类偏好提供反馈,成本高且难以规模化;通过 Value Expert,rollout 已经可以转化为价值评估和 reward 构造,但这还只是起点。更完整的闭环应该让模型在持续 rollout 中自主发现任务进展、失败前兆和轨迹偏好,并将这些信号沉淀为可迭代更新的 reward 与偏好数据,让"执行、预测、评价、再训练"逐步真正运转起来。
VLA 的后训练飞轮,需要一个能模拟动作后果、覆盖失败情形、并给出可优化 reward 信号的世界模型。DW0.5 是朝这个方向迈出的第一步。
成为付费用户可以阅读 原力灵机 所有资料
了解更多 →