过去两年,VLA 模型让机器人迈向了视觉、语言与动作的统一建模。机器人不再只是根据固定程序执行动作, 而是开始理解自然语言指令、识别开放世界中的物体,并将视觉语义转化为可执行的控制信号。在 26 年 2 月, 我们发布了第一代原生具身模型 DM0,也是我们的第一个从零开始搭建的具身基础模型。DM0 能够完成在可控环境下 的一系列复杂动作任务的学习,并向我们初步揭示了这套范式在正确的数据、有效的优化、以及可靠的评测下带来的无限可能。
但真实世界对机器人提出的要求远高于一个精彩 Demo。一个通用机器人基础模型,不能只在固定场景完成既定的任务。 它需要真正理解任务的指令,理解“接下来为什么要这样做”,在不同相机视角、不同物体状态、不同环境、不同机器人本体 和各类干扰下保持稳定可靠执行,并在少量数据微调后快速适应新的真实任务。
这正是我们开发 DM0.5 的出发点:走出实验室,走向开放世界。
DM0.5 的核心优势可以总结为 5个方面
- Zero Shot
- Fine-Tuning
- 长记忆能力
- 动作更加鲁棒
- 多机型支持
- Zero-Shot 能力涌现:这是 DM0.5 核心的提升维度,我们让 VLA 基础模型在真正未知的开放环境,面对用户自然语言的指令来完成任务;
- Fine-Tuning 高效可靠:一个更强的基础模型才能够带来更强的下游专家模型,不仅在特定任务上训练效果更好,成本也更节省;
- 长记忆能力:DM0.5 架构上支持历史信息的学习,最长支持 60s 的记忆;
- 动作更加鲁棒:面对光照、相机视角变化、以及人为主动的干扰,DM0.5 都展现出了非常鲁棒的策略表现;
- 多机型支持:DM0.5 通过多机型多任务的训练,使得模型通过后训练迁移到未见过的机型上。
模型
Overview
DM0.5 延续 VLA 架构,以 4B VLM 作为多模态主干,并配置 680M Action Expert 生成连续机器人动作。 相比 DM0,DM0.5 的重点不只是扩大模型和数据规模,而是在历史上下文、具身推理、动作监督和数据质量上做系统增强, 使模型从当前帧驱动的操作策略,进一步升级为能够理解任务进程、处理开放指令并稳定输出连续动作的机器人基础模型。
围绕真实机器人任务中的长程依赖、语义理解、数据噪声和动作连续性问题,DM0.5 引入了多项关键设计:模型支持长历史输入, 将过去一段时间的关键视觉信息与当前观测共同建模;训练中加入具身推理任务,使模型在动作预测之外持续学习任务阶段、 环境变化和未来动作意图;动作生成在 Flow Matching 的基础上,优化了动作匹配监督,减少遥操作节奏差异带来的时间对齐噪声; 同时,高效的数据清洗管线支持对多来源、多机型、多任务机器人数据进行更精细的清洗、对齐和采样设计,提高动作监督信号的稳定性。
这些设计共同提升了 DM0.5 在开放环境中的指令理解、长程记忆、动作鲁棒性和跨任务泛化能力。模型不仅能够在 zero-shot 场景下 完成更多未见指令,也能在下游 fine-tuning 中更高效地适应真实任务,并在相机变化、人为干扰和不同机器人本体上保持更稳定的执行表现。
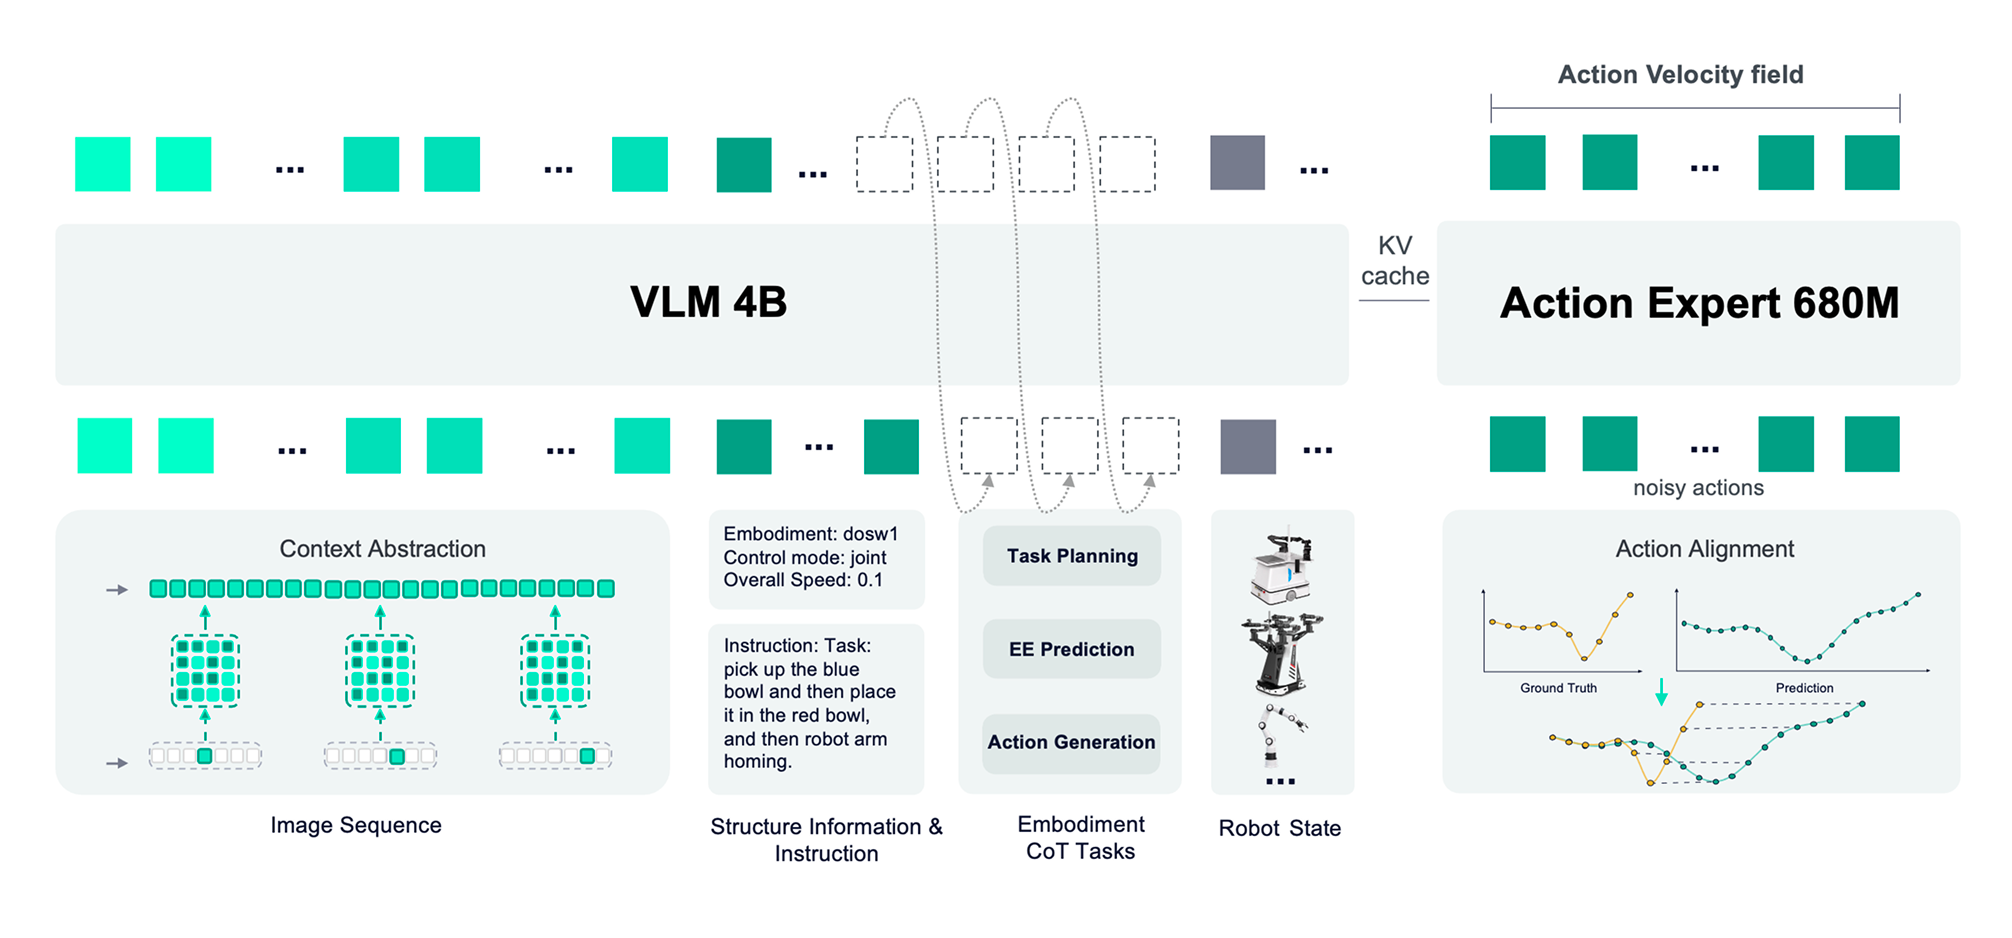
### Context Abstraction Layer:历史信息融合
传统 VLA 模型通常在每个控制步只输入当前图像和当前状态,这种方式适合短时、局部、近似 Markov 的操作任务。DM0.5 通过引入历史帧, 让模型在决策时获得一个短期情境记忆,模型会同时接收当前帧和过去若干关键帧,为模型提供长达 1 分钟的任务进程状态变化: 物体从哪里被拿起,工具是否已经使用,某个区域是否已经被清理,机器人是否已经经过某个地标。
训练时,数据管线从当前时刻向前采样多个历史 slot,每个历史 slot 通过时间采样和空间抽样,合并为固定数量的视觉 token, 采用随机历史长度和历史增强,使模型同时适应长历史、短历史和无有效历史的输入状态。该设计降低了模型对固定历史窗口的依赖, 也让模型在历史缺失或部分失效时仍能退化到当前观测策略。
Embodiment CoT Tasks:广泛的具身推理
尽管具身推理任务不是一件新鲜事,但是 DM0.5 上我们把他做到了极致。这背后的理念是我们认为具身智能的基础模型需要对环境的变化、 指令的理解和意即自身本体的状态和行为有充分的建模,而语言仍然是一种最为高效的表示形式。DM0.5 在机器人数据中引入 11 种不同的自回归任务, 使训练不仅依赖连续动作监督,也持续强化指令遵循、动作预测和时序环境感知。模型需要基于当前图像、机器人状态、任务指令和历史信息回答受约束的问题。
具身推理任务分为 三类
- ##### 任务规划
关注当前任务阶段、前后步骤关系和任务进度,使模型理解“现在做到哪一步、接下来该做什么”。
- ##### 事件与环境预测
关注任务边界、状态变化和未来发生的关键事件,增强模型对场景演化和阶段切换的感知。
- ##### 动作生成
关注未来动作或动作语义摘要,使模型在生成连续动作前形成更清晰的动作意图表征。
该设计的作用是把机器人数据从单一动作监督扩展为“指令理解、时序推理和动作生成”的联合监督。模型不只学习当前画面对应的动作, 还学习在当前指令和任务进程下为什么应该执行这段动作,以及未来世界状态会发生的变化,从而提升复杂长程任务中的指令遵循、 动作连贯性和任务完成率。
Trajectory Alignment Layer:动态动作匹配
机器人采集的数据中,同一任务的多次采集常存在不同执行节奏。如果把模型预测动作与原始轨迹的固定时间位置强绑定, 模型容易学习采集节奏,而不是任务本身的动作规律。因此我们通过动态动作匹配,将监督从“固定时间点对齐”改为“轨迹进展对齐”。
模型输出固定长度的未来动作片段,数据侧保留更细粒度的真实动作轨迹。训练时为每个预测动作在真实轨迹中选择一个动作锚点, 并要求匹配严格单调递增:越靠后的预测动作,只能匹配到越靠后的真实轨迹位置,避免时间反转。每个候选匹配的损失由预测动作与 真实动作锚点之间的误差计算,整体匹配通过动态规划进行计算,使所有预测动作的匹配总损失最小。
为避免匹配只选择局部容易动作,我们进一步考虑了相邻锚点之间的轨迹连续性:不仅单个动作点要接近,相邻锚点之间的真实轨迹也应能被 预测动作变化合理解释。这样既允许合理的速度差异,又减少模型跳过关键动作过程的风险。
该机制能够降低遥操作数据中的时间相位噪声,使模型更关注抓取、对准、接触、释放等任务关键动作变化, 从而提升动作生成的平滑性、鲁棒性和跨采集员节奏泛化能力。
训练
DM0.5 的训练策略以多源数据对齐后的混合训练为核心。机器人操作数据构成动作学习的主体, 视觉语言数据用于维持视觉主干的开放词表理解和空间推理能力,导航数据提供长指令理解与路径决策监督, 视频理解数据进一步增强模型的时序建模、事件理解和动态场景表征能力。
在优化策略上,视觉语言主干与动作专家采用分组学习率。视觉语言主干使用较小学习率,以降低灾难性遗忘并稳定保留通用视觉语言能力; 动作专家使用更大学习率,以充分学习机器人动作分布。训练过程采用混合精度和分布式训练,并对动作专家进行独立的训练优化, 以支持长上下文、多相机输入和 history token 带来的额外计算开销。
推理
DM0.5 推理以 Action Chunk 为单位执行,默认使用 10 个 diffusion / Flow Matching steps 生成一个 50 步 chunk。 经过优化后,DM0.5 在 4090 单卡上的推理速度能够做到 10Hz,在 H100 单卡上做到 20Hz。
数据
数据构成
DM0.5 使用大规模异构数据进行预训练,覆盖机器人操作、具身导航、第一人称人类操作以及通用多模态视觉语言数据等多个来源。
- #### 机器人操作数据:
包含来自多种机器人本体的真实操作数据,包括松灵 ALOHA、Galaxea R1 Lite、AgiBot G1、Franka Emika Panda、UR5、ARX5,以及 Dexmal 自研双臂移动操作机器人。
- #### 具身导航数据:
包括一系列开源视觉语言导航与开放词汇导航数据集,以及自采集 3D 重建场景下的导航数据。
- #### 第一人称人类操作数据:
采集自日常生产环境中的人类第一视角操作过程,包含丰富的手部交互、工具使用、物体操作和细粒度原子动作。
- #### 通用多模态视觉语言数据:
引入图像、视频和视觉指令数据,并构建自动生成管线增强空间定位、未来状态预测、动作后果分析和反事实推理能力。
数据清洗策略
异常值去除:机器人在 ROS 数据记录过程中偶尔会产生异常的极大值、极小值或突变值。为避免此类异常样本对模型训练造成干扰,我们过滤了明显超出物理可达范围或不满足运动连续性的样本。此外,我们还检查了视觉输入与机器人状态、动作标签之间的一致性,并剔除了图像画面中存在明显移动或摇动、但对应的机器人状态与动作记录未体现相应运动的片段,从而保证多种模态数据的时序一致性与语义对齐。
静止帧去除:数据中常包含图像画面与机器人状态长时间保持静止的片段。此类样本动作信息量有限,容易降低训练效率,并可能影响模型在实际部署时的动作响应能力。因此,我们在训练前移除了长时间无有效状态变化或动作变化的静止片段,以提升数据的有效动作密度。
无价值动作去除:数据中常出现动作执行不到位、操作意图不明确,或与当前任务目标无关的行为片段。这类数据可能引入噪声监督信号,降低策略学习的稳定性与泛化能力。为提高训练数据质量,我们去除了此类无效或低价值动作片段,使保留数据更准确地反映任务相关的操作行为。
动作模式去重:对于部分机械臂平台,例如 ALOHA,不同关节组合可能对应近似等价的末端执行器运动模式。为避免模型学习到不一致或相互混淆的关节映射关系,我们对这类等价运动模式进行去重,仅保留统一且一致的关节表示,从而提升动作监督信号的确定性。
错误标注重新标注:针对原始数据中可能存在的任务标注错误,我们构建了一套自动化重新标注管线,对子任务标签进行跨模态一致性校验与修正。通过这种方式,我们能够在不大量丢弃数据的前提下修正错误标注,提升子任务标签与真实操作过程之间的一致性,并进一步提高训练数据的可靠性和利用率。
实验
Zero-Shot 能力
任务介绍
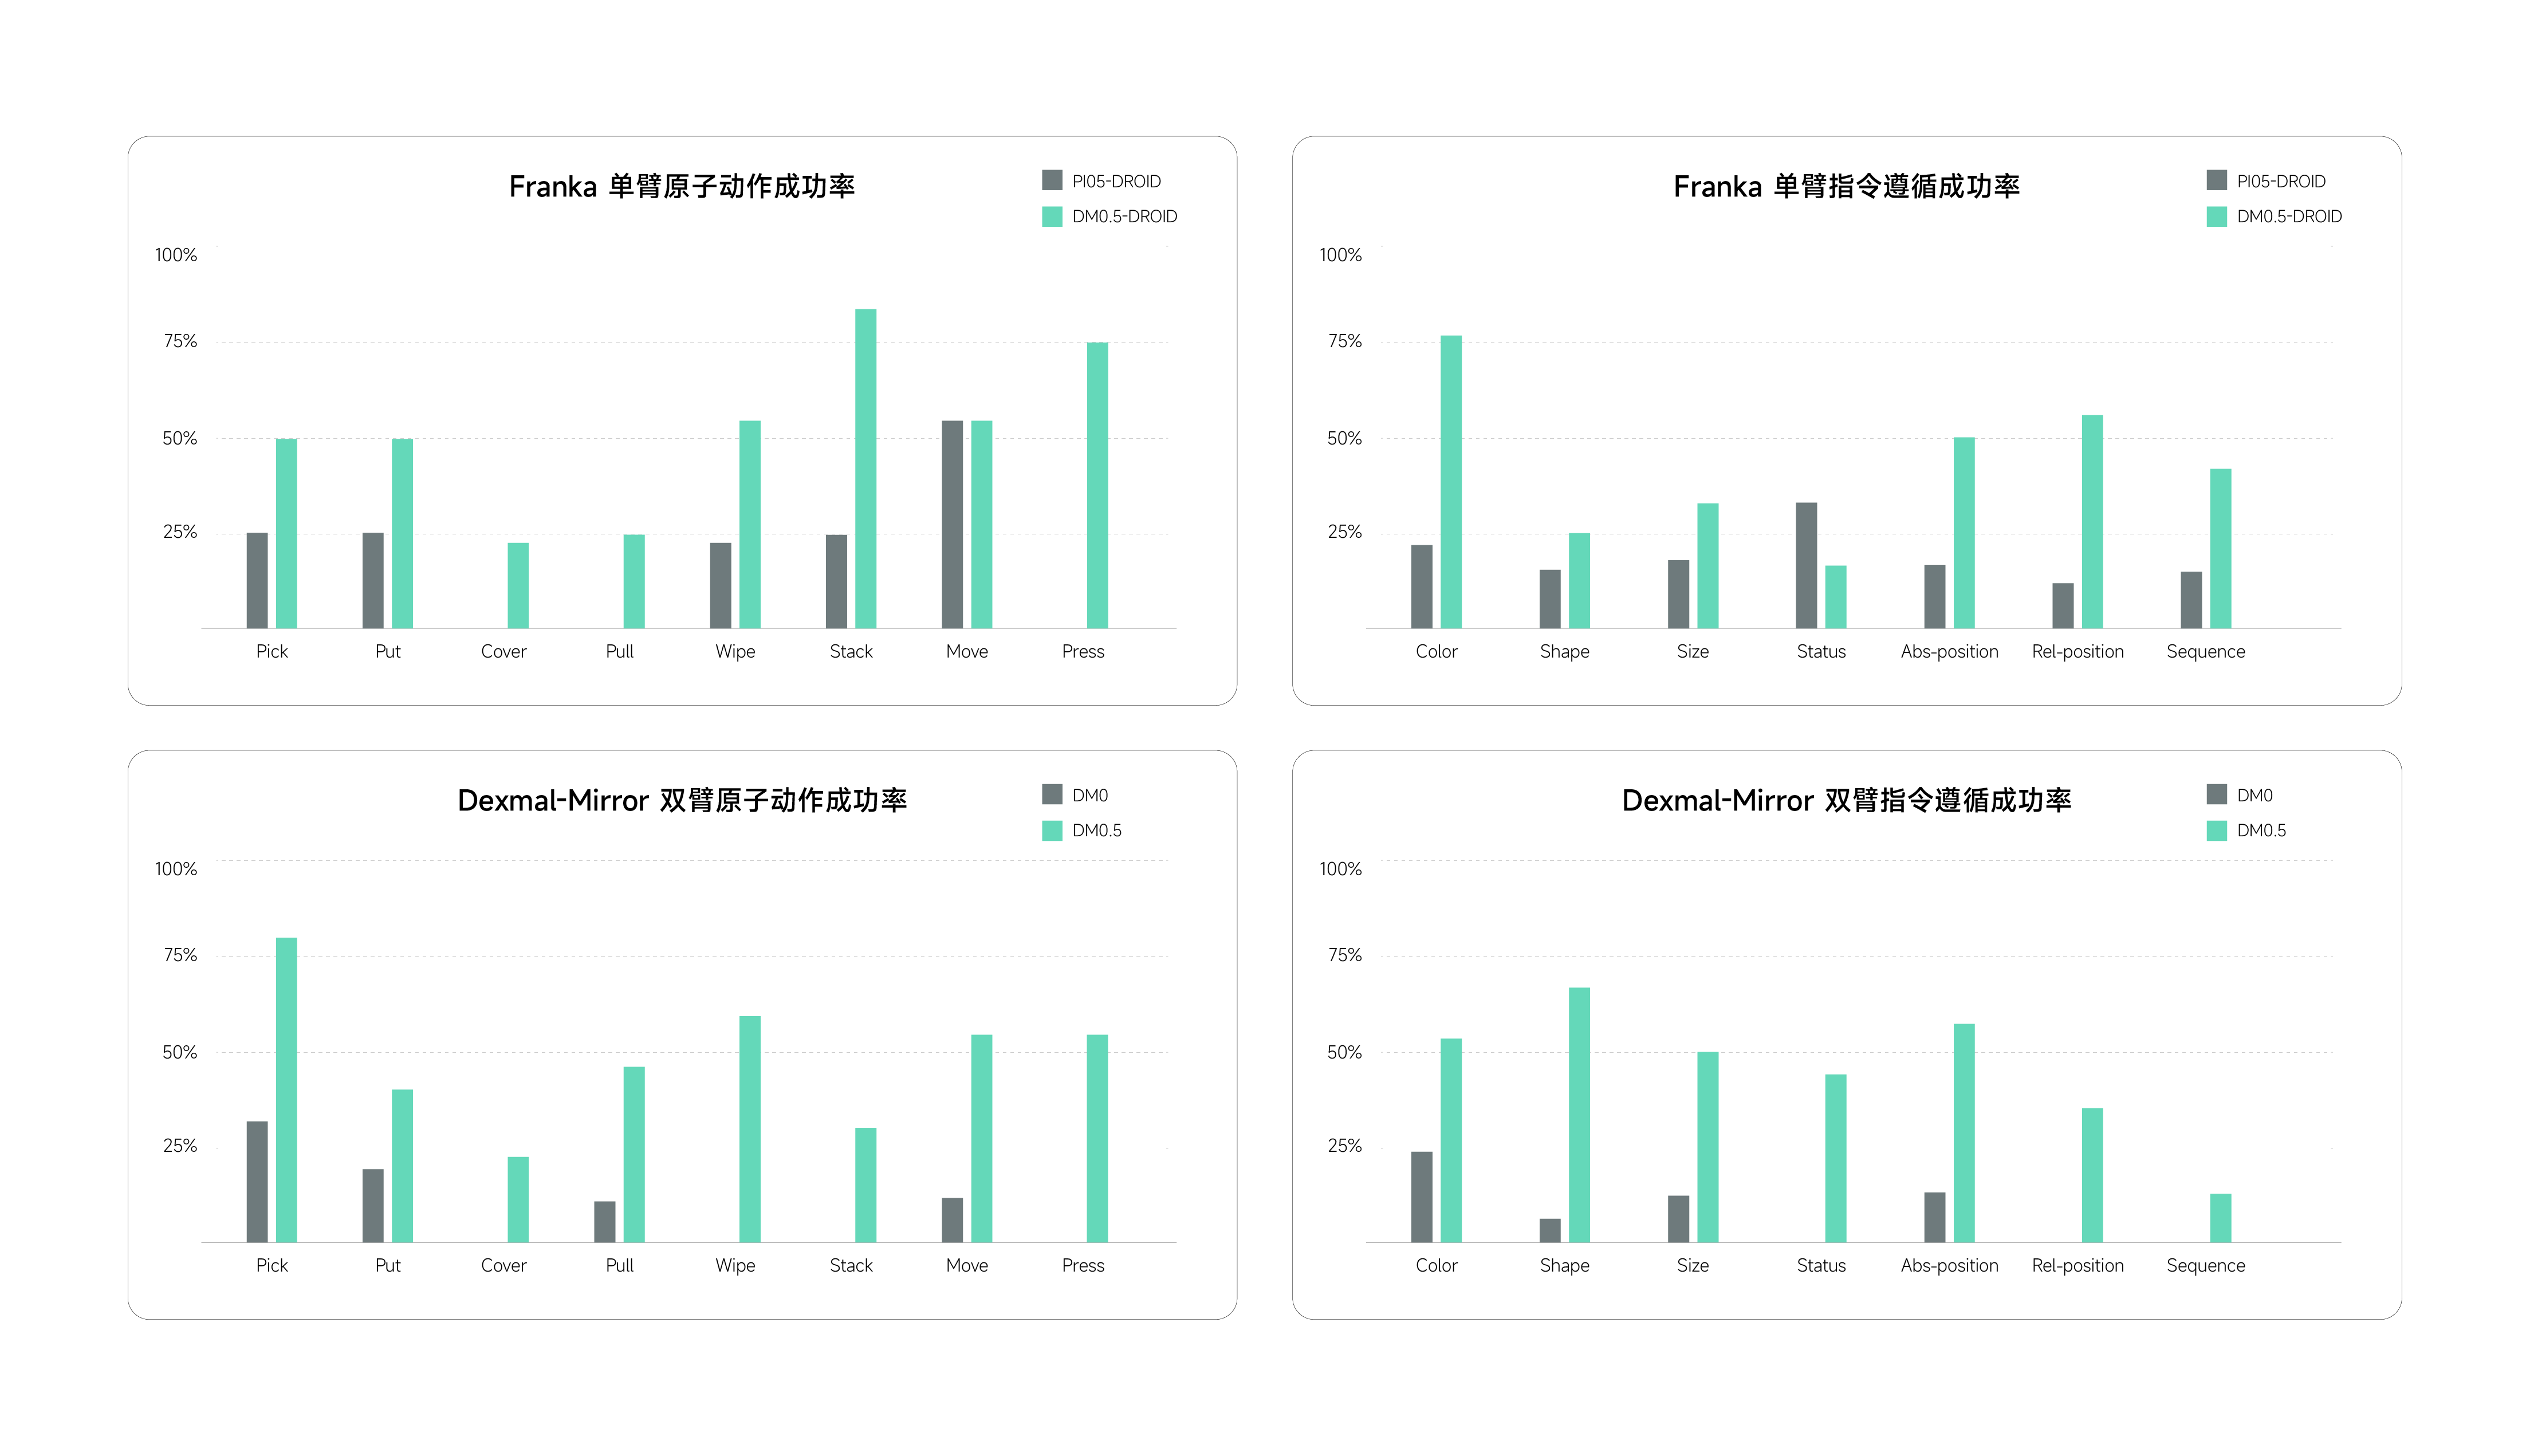
为评估模型在未见任务配置下的零样本(Zero-Shot)泛化能力,我们从动作类型与条件约束两个维度系统考察模型的性能。 其中,动作维度涵盖以下 8 类基础操作原语:pick、put、move、pull、cover、wipe、stack、press;条件维度则包括颜色(color)、 形状(shape)、尺寸(size)、状态(status)、执行序列(sequence)、相对位置(relative position)及绝对位置(absolute position)共 7 类语义约束。
每个测试任务均由至少一个动作原语构成,并根据设计可选配若干条件约束,以模拟真实操作中指令的多样性与组合复杂度。 在上述任务集上,我们选取了四组模型 X 平台的组合开展对比评测:在 Franka 平台部署 Pi0.5-Droid 与 DM0.5-Droid 两个模型; 在 Dexmal-Mirror 平台部署 DM0 与 DM0.5 两个模型。
结果分析
各动作类别及条件维度下的任务成功率分别汇总于表 1 和表 2。实验结果表明,DM0.5 在绝大多数评测维度上均显著优于 PI05-Droid 和 DM0, 展现出更强的指令理解与执行能力。整体来看,DM0.5 已形成较为系统的 Zero-Shot 动作执行与语言条件理解能力, 提升主要体现在动作覆盖范围扩大、基础操作稳定性增强,以及对多类语义约束的指令遵循能力提升。
### Fine tuning能力
抓取场景真机测试 RoboChallenge Table30 V2
我们使用 RoboChallenge Table30 v2 评测 DM0.5 的真实机器人桌面操作能力。该评测覆盖多类真实桌面操作场景,包括长期记忆、 多步顺序执行、视觉感知与目标定位、精细抓放、工具交互以及双手协同等任务类型。同时,该评测采用 Generalist Setting, 每个测试机型训练一个统一模型,能够更加全面地检验 VLA 模型在真实环境中的操作泛化能力。
实验结果表明,DM0.5 在 Table30 v2 上取得了 SOTA 的整体效果,整体 Success Rate 为 43%,综合 Score 为 54.42。 在盖章定位、按按钮等需要记忆目标状态和动作顺序的任务中,DM0.5 的记忆能力显著提升了执行稳定性。
同时,依托强大的视觉-语言-动作预训练,DM0.5 在复杂精细操作上也表现出色。对于双手托盘等双臂协同任务, 模型能够较稳定地控制相对位姿和运输过程;对于插花等需要物体识别、抓取姿态选择和精细放置的任务, 模型展现出较强的视觉 Grounding 和末端控制能力。
总体来看,Table30 v2 的结果说明 DM0.5 不仅在记忆型任务上受益明显,也能在双臂协同和精细操作任务中保持领先表现, 验证了其在真实机器人多任务 Generalist Policy 场景下的有效性。
抓取场景仿真测试
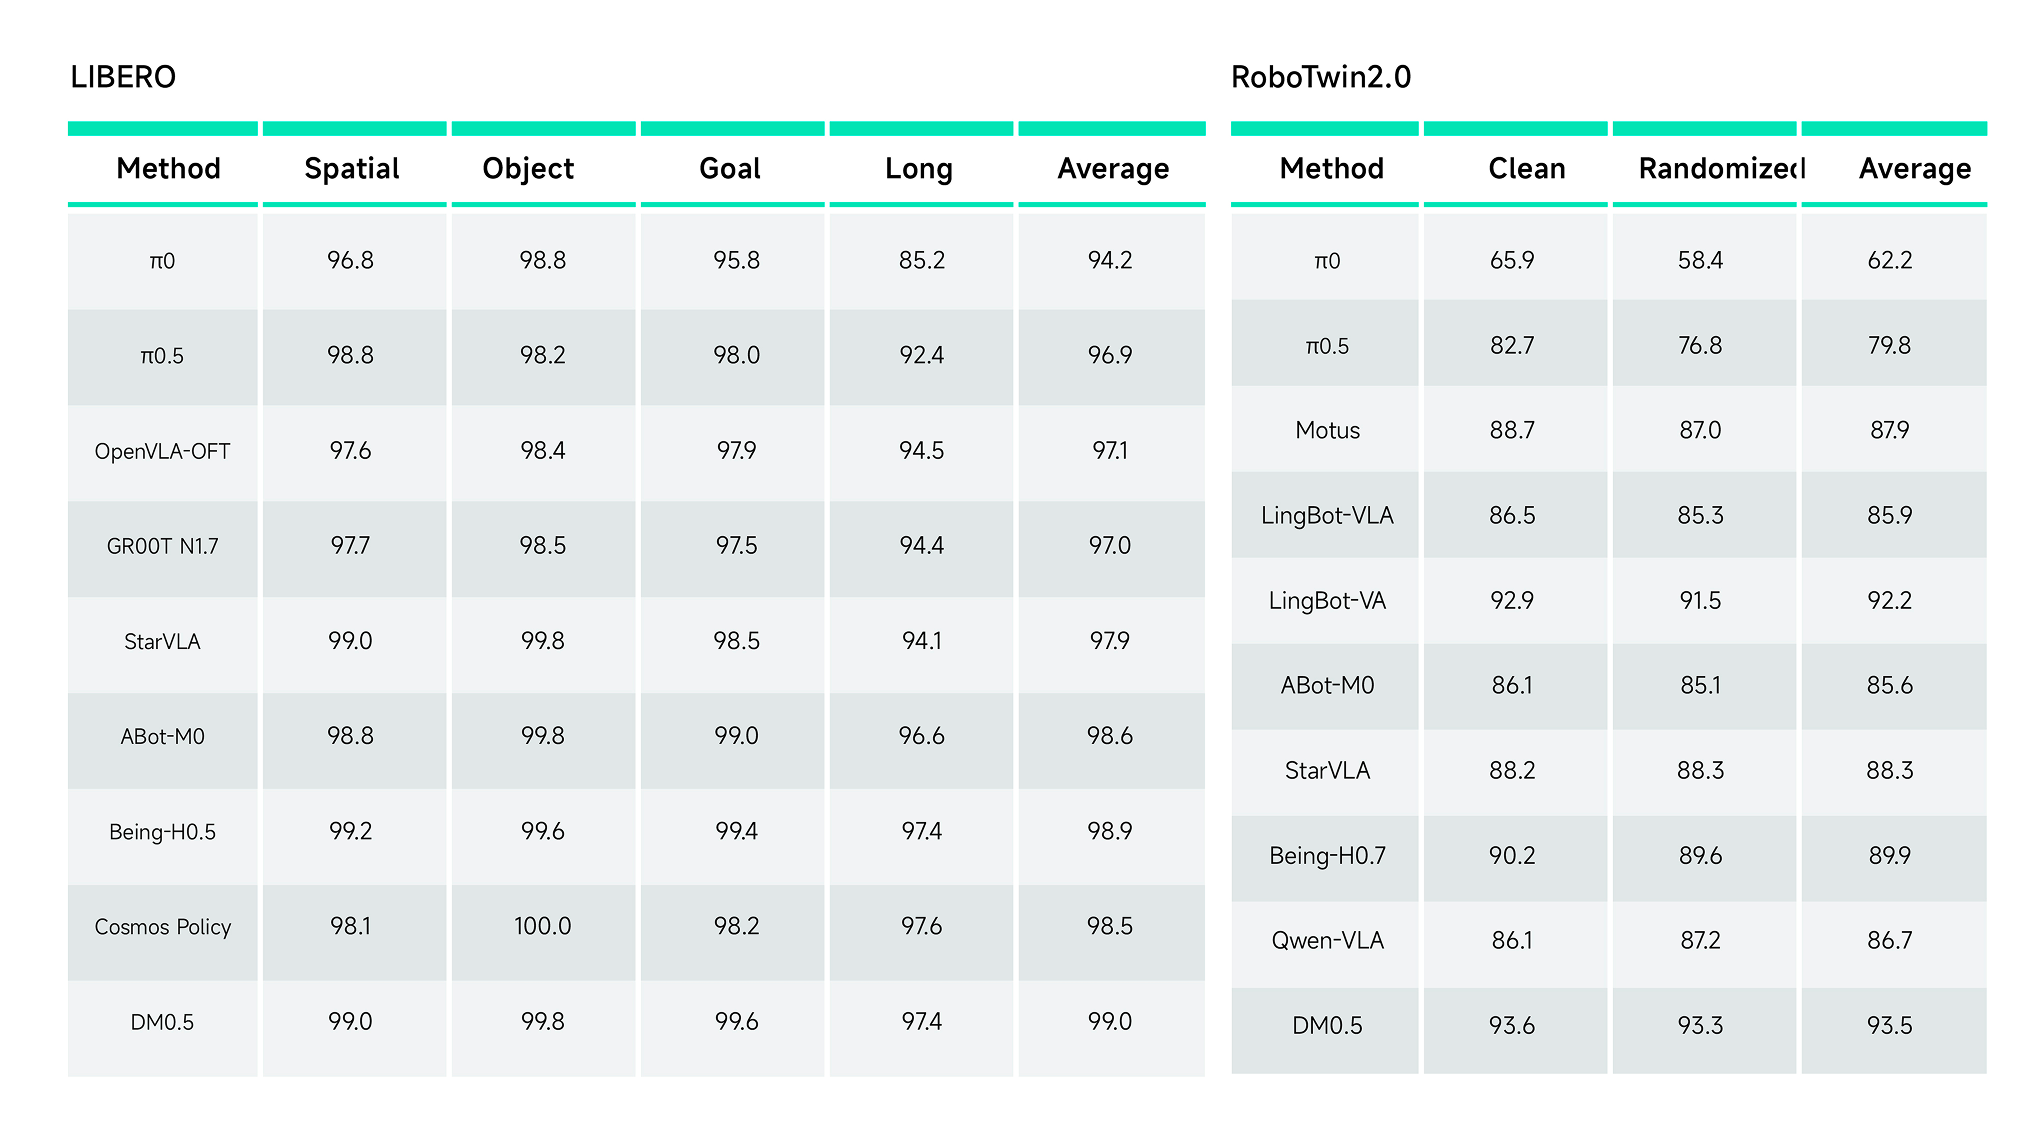
我们在两个广泛使用的仿真基准中评估了 DM0.5 的微调能力:单臂操作环境 Libero 与双臂操作环境 RoboTwin2.0。 实验结果表明,微调后的 DM0.5 在两类场景中均展现出强大的任务适应能力,并能够达到当前最先进方法的性能水平。
#### 导航场景仿真测试
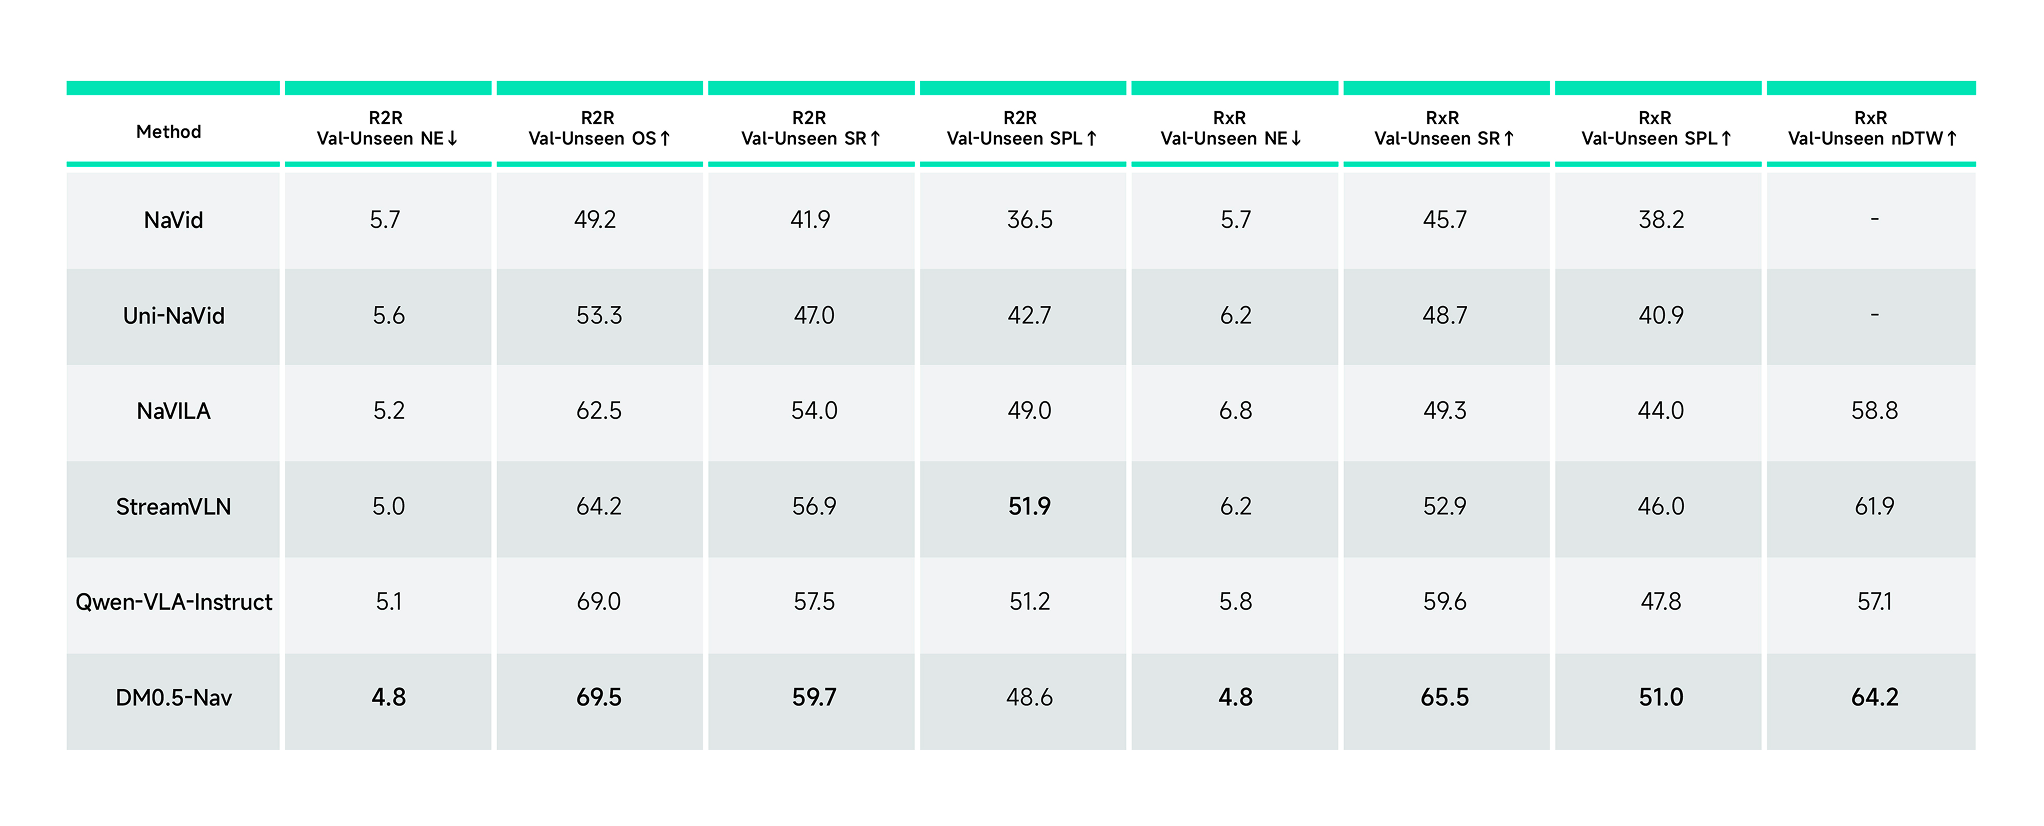
我们使用在 R2R 和 RxR 两个基准评测 DM0.5 在导航上的性能,DM0.5 在大多数评测指标上均取得了最佳性能。 在 R2R Val-Unseen 数据集上,其 Navigation Error(4.8) 和 Success Rate(59.7) 均达到最高。 在更具挑战性的 RxR Val-Unseen 数据集上,DM0.5-Nav 在所有四项指标上均位居第一。
### 历史记忆能力
历史记忆能力用于衡量模型是否能够将过去观测整合为当前决策的上下文。对于具身任务而言,许多关键条件并不总是出现在当前帧中: 物体可能已经被移动,桌面状态会随动作发生变化,任务规则也可能只在 episode 早期通过人类示范出现。为验证这种情境记忆理解能力, DM0.5 在 Dexmal-Mirror 上构建了两个真实场景实验,分别对应短程情境记忆和长程情境记忆。
第一个实验是“拿起杯子擦桌子”,用于评估短程记忆:机器人需要先拿起杯子,让杯子下方的桌面区域暴露出来;随后擦拭桌面; 最后将杯子放回最初的位置。杯子被拿起后,当前画面里已经不再直接包含杯子的初始位置信息。仅依赖当前帧时,模型缺少“杯子原来在哪里”的信息, 因此容易出现随机放置、靠近当前位置放置或放置偏移较大的问题。DM0.5 则可以通过历史视觉记忆恢复杯子的初始位置,并在任务结束时完成复位。
“人类示范学习”实验,用于评估长程记忆。在任务开始,人类会先进行一次规则展示,机器人需要观察示范中电池的放置方式, 并在后续机器人执行阶段保持这一规则。与短程擦桌不同,放电池任务中的决策依据不一定存在于当前视野,而是依赖早期示范与当前执行状态之间的关联。 DM0.5 同样使用超过一分钟的历史视觉信息,使模型能够将早期示范转化为后续操作策略,并在跨阶段执行中保持规则一致性。
这两个实验从互补的时间尺度展示了 DM0.5 的情境记忆能力。“拿起杯子擦桌子”验证了模型能利用近期历史追踪物体状态和任务进度; “模仿人类示范放电池”验证了模型能保留早期示范并将其约束到后续机器人动作中。二者共同说明,预训练阶段形成的情境记忆表征可以在下游 SFT 中被激活, 并参与视觉语言条件下的动作预测。同时,在“人类示范学习”的例子也进一步说明了,在历史记忆的能力下,Video Prompt 能够成为一种新的指令表述形式, 让机器人能够以 In Context Learning 的方式完成新的任务。
策略鲁棒性
相机变化
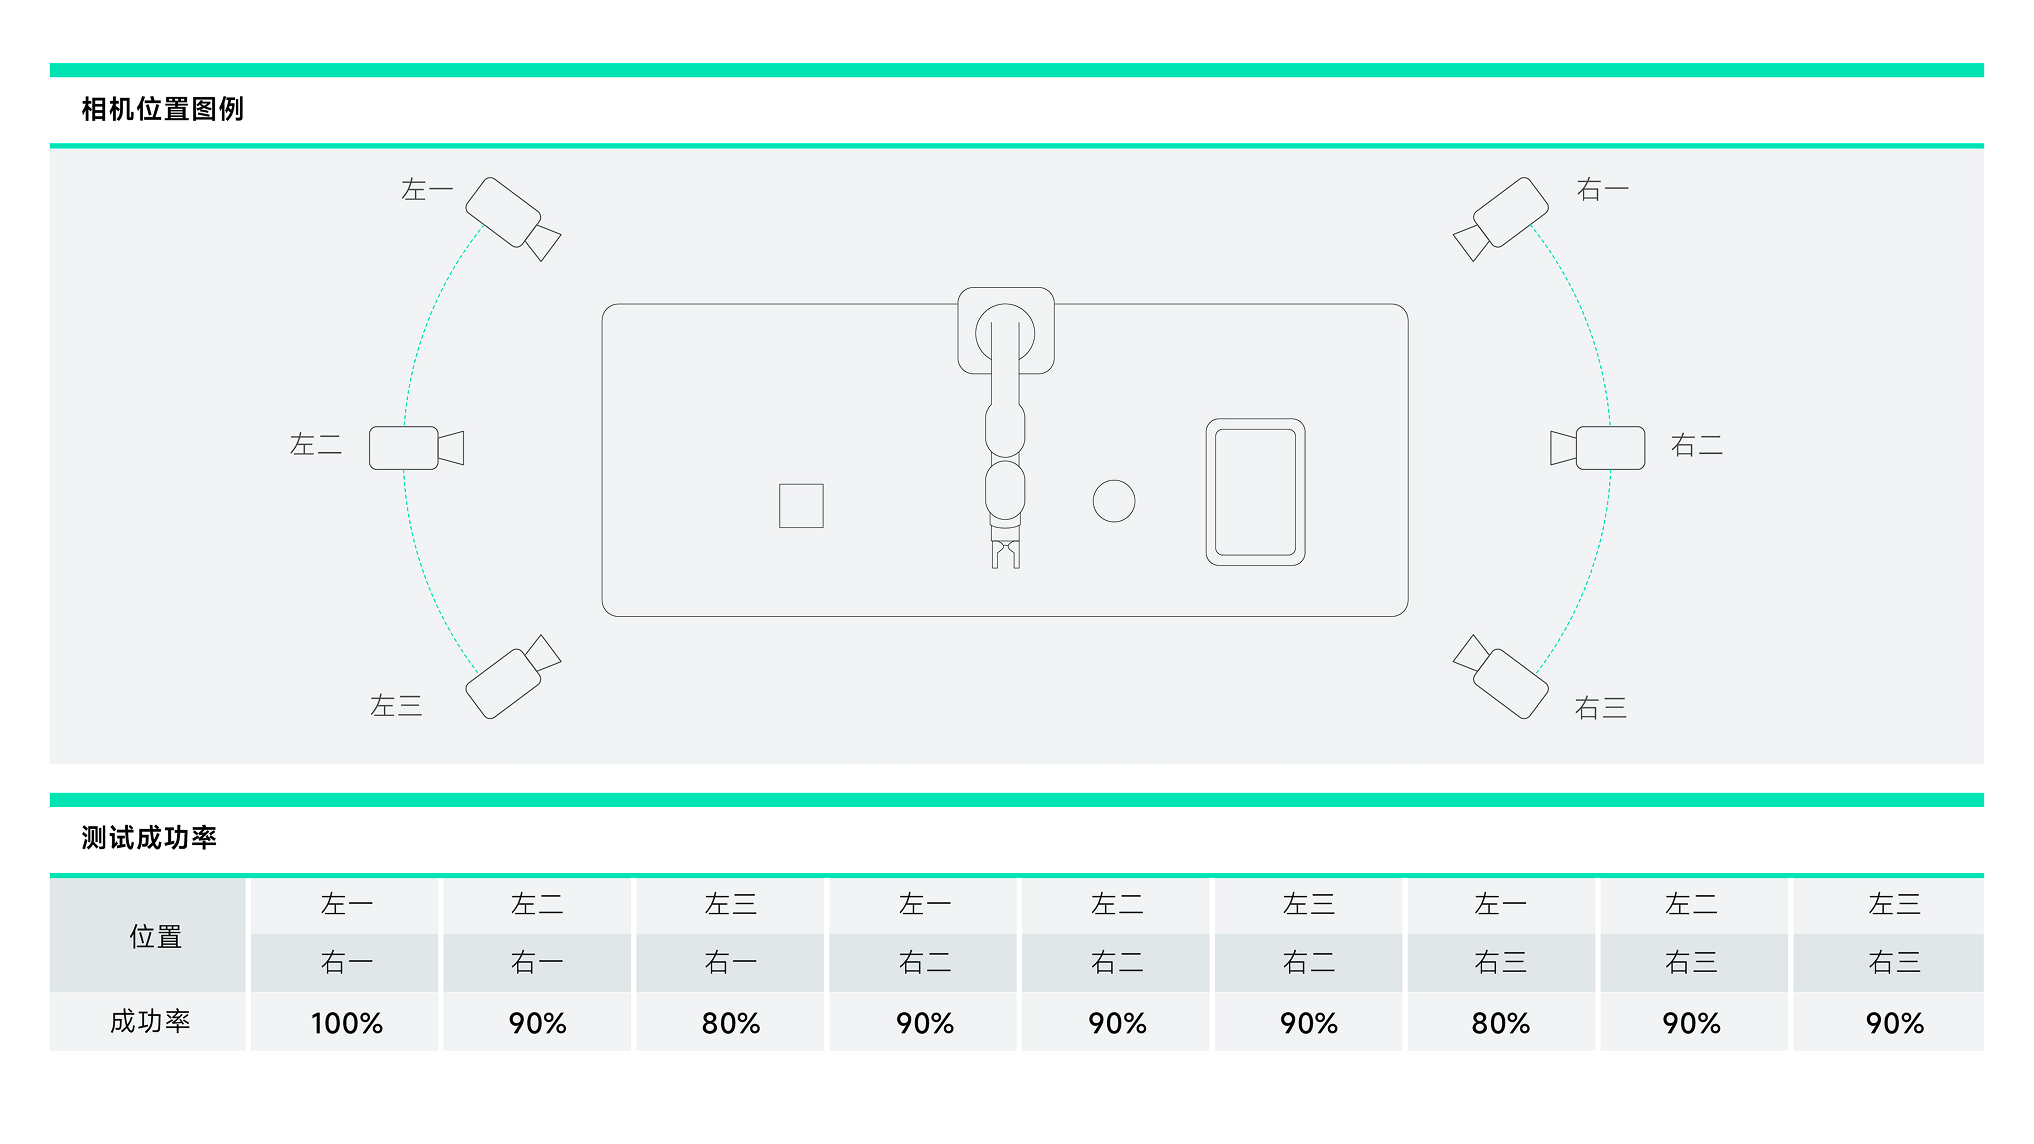
在 Franka 平台测试中,我们部署的设备包含一台固定于机械臂末端的腕部相机和两台可独立自由移动的第三视角相机, 旨在定量评估相机空间位姿变化对模型操作性能的影响。实验设计了左右两侧各三个不同拍摄位姿,共计九组测试配置。
实验数据显示,尽管第三视角相机的位置发生变化,整体任务成功率仅呈现轻微波动,未出现系统性显著下降, 表明模型在不同视角条件下具备较强的鲁棒性。进一步观察模型运动轨迹发现,其行为呈现出明显的两阶段策略: 初始阶段,模型依据第三视角相机获取的全局场景信息,将末端执行器引导至目标物体附近区域;随后, 以腕部固定相机提供的局部视觉反馈为核心感知,执行精细的位置调整与对齐操作。
值得注意的是,当相机位于左侧第三个位置(左三)与右侧第三个位置(右三)时,第一阶段“粗定位”阶段产生的空间偏差显著大于其他位置。 然而,在绝大部分试验中,模型仍能依靠腕部相机的局部精调能力有效补偿该偏差,并最终成功完成任务。
#### 人为干扰
为评估 DM0.5 模型在真实机器人操作环境中的鲁棒性,我们在 Dexmal-Mirror 机型上进行了人为干扰条件下的真机测试。 结果表明,在 Dexmal-Mirror 机型上,DM0.5 在人为移动目标以及短时遮挡的情况下,仍能保持对当前场景的理解,并持续推进任务流程。 当容器位置和朝向发生变化后,模型没有依赖原始固定轨迹,而是根据新的视觉状态重新调整机械臂末端位置与动作方向,继续完成对目标物体的操作。
这一表现说明 DM0.5 具备较强的动态场景适应能力和任务连续性。在外部扰动改变物体与容器空间关系后, 模型仍能重新建立目标物、容器和机械臂之间的空间对应关系,避免因局部环境变化导致任务中断或动作失效。
总体来看,DM0.5 在人为干扰场景下展现出良好的抗干扰性能。其能力主要来自大量丰富、真实的真机数据,以及模型对视觉状态、 空间关系和动作映射的高效学习,使其能够在复杂、动态的真实操作环境中保持稳定执行。
结语
面向开放世界的能力建设,不是把更多任务装进模型,而是拒绝用“任务表”来冒充“世界”。
我们相信,让模型跳出“剧本环境”,以面向真实世界的方式,尽最大可能让开放世界本身成为模型训练的“环境”, 是走向通用具身智能的最快路径。
DM0.5 正是沿着这条路径迈出的一步。它让机器人开始拥有更长的记忆、更开放的理解、更稳定的行动, 但更重要的是,它让机器人第一次真正开始面对一个没有标准答案的世界。
成为付费用户可以阅读 原力灵机 所有资料
了解更多 →