新华社北京9月15日电 9月15日,《新华每日电讯》发表题为《数据:99%+1%,能实现“从0到10000”——银河通用王鹤:让机器人甩掉遥控器,“睁开眼”干活》的报道。
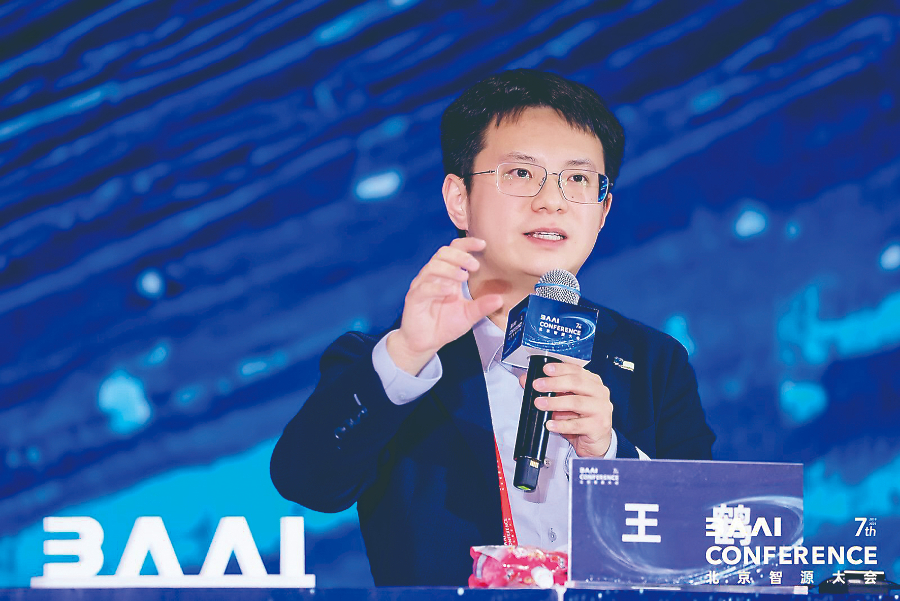
北京银河通用机器人有限公司创始人兼首席技术官王鹤。(受访者供图)
8月,全球首个城市级常态化运营的人形机器人示范区落地北京。来自北京银河通用机器人有限公司的“银河太空舱”——由机器人经营的无人超市开张,具身智能真正走进大众日常生活。作为专注于研发人形机器人硬件和具身智能大模型的机器人企业,银河通用率先实现机器人在工业、零售等场景批量化落地,其自研机器人Galbot在机器人格斗赛等赛事上也斩获佳绩。
每次有机器人火上热搜,评论区都有不少人强调一个现实:目前,绝大多数机器人离开人工和遥控,还是会“原形毕露”。
而银河通用的机器人Galbot却有所不同:它不仅无需“遥控”,还能自主干活。
眼下,具身智能的最大困境,既非硬件,也非模型,而在于数据。不论是让机器人从动作智能转向认知智能,还是提升机器人的泛化性、鲁棒性(指系统、算法或模型面对外部干扰、输入异常或内部参数变化时维持稳定运行并输出预期结果的能力),关键在于数据的丰富性和准确性。
而一个让难度再进阶的考验是,想要真正实现商业闭环,还要权衡数据获取的质量、成本与效率。
记者:机器人发展的优先级,应侧重于能力的展示,还是产业的切实赋能?在发展方向上,业内分歧多还是共识多?
王鹤:今年以来,机器人企业在两种能力的选择上逐步有了区分度。一类以宇树科技为代表,其机器人擅长运动、舞蹈、拳击,特点是以腿足乃至全身控制为主,能展现出精彩的运动能力。还有一类是以银河通用为代表的“干活派”,依靠视觉反馈闭环,展现出在实际场景中干活的能力。“干活派”里,大致还可分为视觉算法+轨迹生成,与端到端VLA(即视觉-运动-动作一体化生成)两种技术路径。
其实,不少人形机器人跳舞、跑步,并没有用到视觉传感器。今年4月在北京举行的全球首个机器人半程马拉松上,不少观众注意到部分机器人“运动员”的不远处,有人用遥控器遥控机器人跑步、转弯或加速,实际上机器人是“闭着眼”跑的。这样的技术现状跟机器人“生产力时代”还不是一回事,毕竟,没有活是闭着眼睛干的。
今年,具身智能的场景落地在加快。以工业场景为例,银河通用的机器人已实现流水线搬运、分拣等环节的规模化应用。零售场景中,银河通用在北京海淀已成功落地10多家配备人形机器人的智慧药房,并计划年内在全国开设100家。此外,银河通用的机器人已开始售卖零食、咖啡等商品。
记者:机器人完成酷炫的、令人眼前一亮的动作,许多情况下还是预编排的动作序列、人工遥控与视频剪辑共同作用的结果。为什么会出现“demo(演示视频)先行、落地乏力”?
王鹤:秀一段5分钟的demo,对机器人的可靠性、稳定性要求并不高,不能证明它是能24小时工作的高可靠性产品。
demo与产品的差距主要来自两方面。一是泛化性不足,视频片段展示的多为精心布置的受控环境,如果换个物体、环境甚至是光线,机器人就难以工作了,这显然还不是成熟的产品。二是硬件不可靠,如果机器人用上一会儿就需要人来维修,也显然还不能大规模投入使用。机器人的核心功能是替人去劳动,而不是成为花瓶一样的摆设。
记者:要想“拿掉机器人的遥控器”,核心在于什么?
王鹤:在于能够自主执行的模型“大脑”,且能实现跨场景泛化。今年初,银河通用以10亿级合成大数据,端到端训练了一个VLA大模型,以视觉作为输入,模型实时输出当前机器人末端执行器应当如何移动,是一个闭环反馈模型,能够实现对不同场景中移动物体的抓取。6月,又推出了端到端导航大模型,使机器人能够拥有“听—看—懂—走”闭环运动能力。
另一个核心在于硬件的性能要够用、好用,精度要尽可能高。
记者:机器人实现泛化的关键在于什么?
王鹤:数据。可以说数据决定了机器人能力的下限。
我的观点是,现阶段合成数据可用于解决从0到1的问题,利用真实遥操采集的数据可解决从1到100的问题,从100到10000的问题则交由视频数据处理,让机器进行学习。具身智能所依靠的数据,99%可借助高质量的合成数据完成,只有在合成数据无法处理的情况下,才需要有针对性地采集使用1%的真实数据。
端到端具身大模型面临的困难,与自动驾驶所运用的端到端大模型有所不同。自动驾驶所依靠的数据来源广泛、数量庞大,且采集成本为负。目前,头部人形机器人厂商量产的机器人仅为千台级别,难以达到万台规模。在现实中,让所有机器人都投入不同场景自主工作,以供真人采集上亿条数据,并不具有现实可行性。
更为切实可行的解决方案是,先利用合成数据完善抓取、移动、放置等功能,助力具身智能开拓市场,先完成那99%。而生成高质量合成数据也存在一定门槛,需具备出色的图形学、物理仿真、物理渲染、自动动作合成管线等一系列完整的基础设施,还需要长期的核心技术积累。
成为付费用户可以阅读 银河通用 所有资料
了解更多 →